記事の要約
- SLMとは、数億〜数十億パラメータという「規模」の呼び名であり、ローカルLLMは自社環境で動かすという「場所」の呼び名で、2つは別の軸の分類です。
- 入力に答えの材料が揃う分類・抽出・定型文・RAGの回答生成はSLMで足り、多段の推論や長文の要約のように判断を組み立てる業務は大きなモデルが向きます。
- Phi-4-mini・Gemma 3・Qwen3・TinySwallow・Sarashina2.2などの小型モデルを、小さい規模から同じ評価データで試す進め方が堅実です。
「ローカルLLMとSLM、どちらを選べばよいのかわからない」「社内サーバーで動く規模のモデルで、業務に使える精度が出るのか知りたい」。DX推進担当者からの相談が増えています。
本記事では、ローカルLLMとSLMの違いを5つの軸で整理し、SLMで足りる業務と大きなモデルが要る業務の判断基準を示します。公式情報で確認した代表的なSLMと、PoCから本番までの進め方も解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社の経験も踏まえてまとめました。
目次
SLMとは?ローカルLLMとの違いは「規模」と「動かす場所」
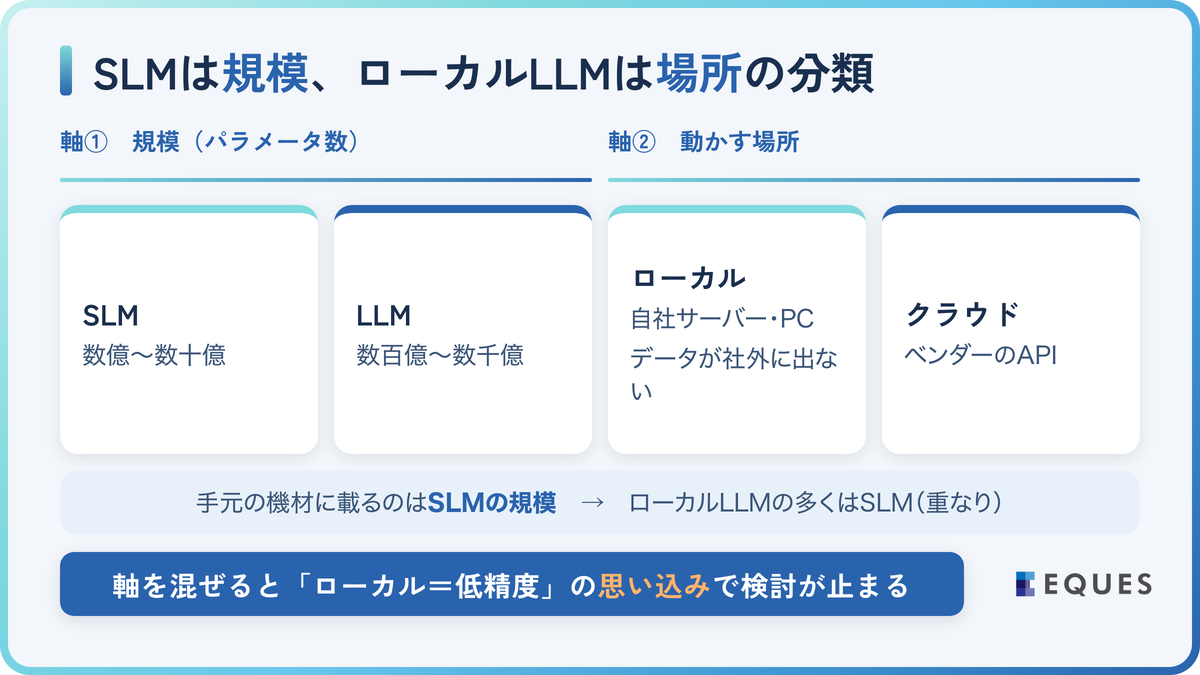
SLM(Small Language Model:小規模言語モデル)とは、パラメータ数が数億〜数十億程度に抑えられた言語モデルです。パラメータ(=学習で調整されるモデル内部の数値)が少ないほど、必要なメモリと計算量は小さくなります。
対になるLLM(Large Language Model:大規模言語モデル)は、数百億〜数千億規模のモデルです。両者の境界に公的な定義はなく、「規模」という同じ軸の上での呼び分けにすぎません。
一方、ローカルLLMは自社のサーバーやPCなど、手元の環境で動かす言語モデルを指します。クラウドのAPIを使わないため、入力したデータが社外に出ない点が特徴です。
つまりSLMは「モデルの大きさ」、ローカルLLMは「動かす場所」を表しており、2つは別の軸の分類です。
モデルは重み(=学習済みのパラメータの値)がすべてメモリに載って初めて動くため、大きなモデルには複数GPUや専用サーバーが要り、手元の機材に収まるのはSLMの規模です。その結果、ローカルLLMの多くがSLMであるという重なりが生まれます。
軸を混ぜて考えると「ローカル=精度が低い」と思い込んで検討が止まり、クラウドで動かすSLMも候補から消えて、要件定義のやり直しになります。
ローカルLLMの仕組みと必要なPCスペックは「ローカルLLMとは?仕組みとメリット・必要なPCスペック2026」で解説しています。
ローカルLLMとSLMの違いを5つの軸で比較
比較すべきは規模・動かす場所・用途・必要なGPU・精度の傾向の5点です。
| 比較軸 | SLM | LLM(クラウド提供) | ローカルLLM |
|---|---|---|---|
| 規模(パラメータ) | 数億〜数十億 | 数百億〜数千億 | 手元の機材で動く規模 |
| 動かす場所 | 手元でもクラウドでも可 | 原則ベンダーのクラウド | 自社サーバー・PC |
| 向く用途 | 分類・抽出・定型文・RAGの回答 | 複雑な推論・長文要約・多段の手順 | 機密データを扱う業務 |
| 必要なGPU | 1枚程度、小型なら不要の場合も | 利用者側は不要 | モデルの規模に応じて自社で用意 |
| 精度の傾向 | タスクを絞れば実用水準 | 幅広い問いに安定 | 選んだモデルの規模で決まる |
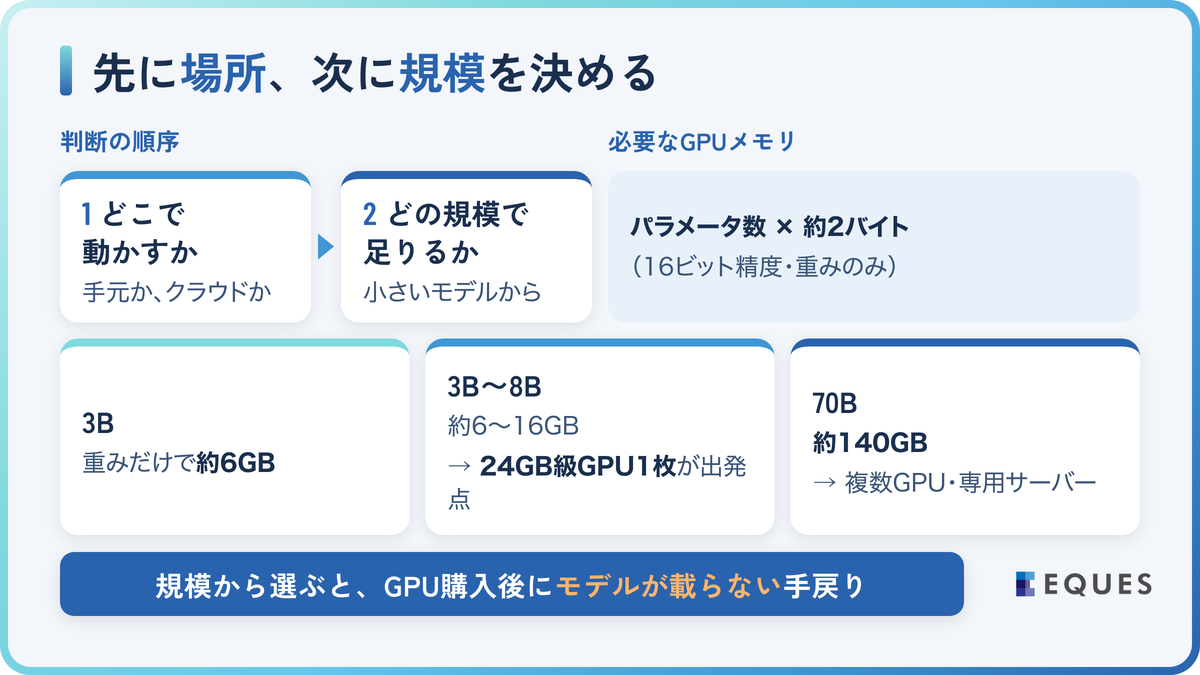
必要なGPUメモリの目安は、パラメータ数に1パラメータあたりのバイト数をかけた値です。16ビット精度では1パラメータ約2バイトで、30億(3B)のモデルは重みだけで約6GB、700億(70B)なら約140GBが必要になります。
量子化(=重みを4〜8ビットに圧縮して容量を減らす技術)を使えば数分の1に縮みますが、規模が1桁違えば必要な機材も1桁変わる構図は残ります。
検証では、実行ツールのOllamaやllama.cppを使えば、公開モデルを社内サーバーやPCで動かせます。上の式では3B〜8Bの重みは16ビットで約6〜16GBなので、24GB級GPU1枚が検証の出発点になります。
判断の順序は、先に「どこで動かすか」を決め、次に「どの規模で足りるか」を選ぶ形です。逆の順で規模から選ぶと、GPUの購入後に必要なモデルが載らないという手戻りが起きます。
構築・運用の費用は「ローカルLLMの費用相場|構築・運用コストと料金の考え方2026」をご参照ください。
SLMで足りる業務とLLMが要る業務の判断基準
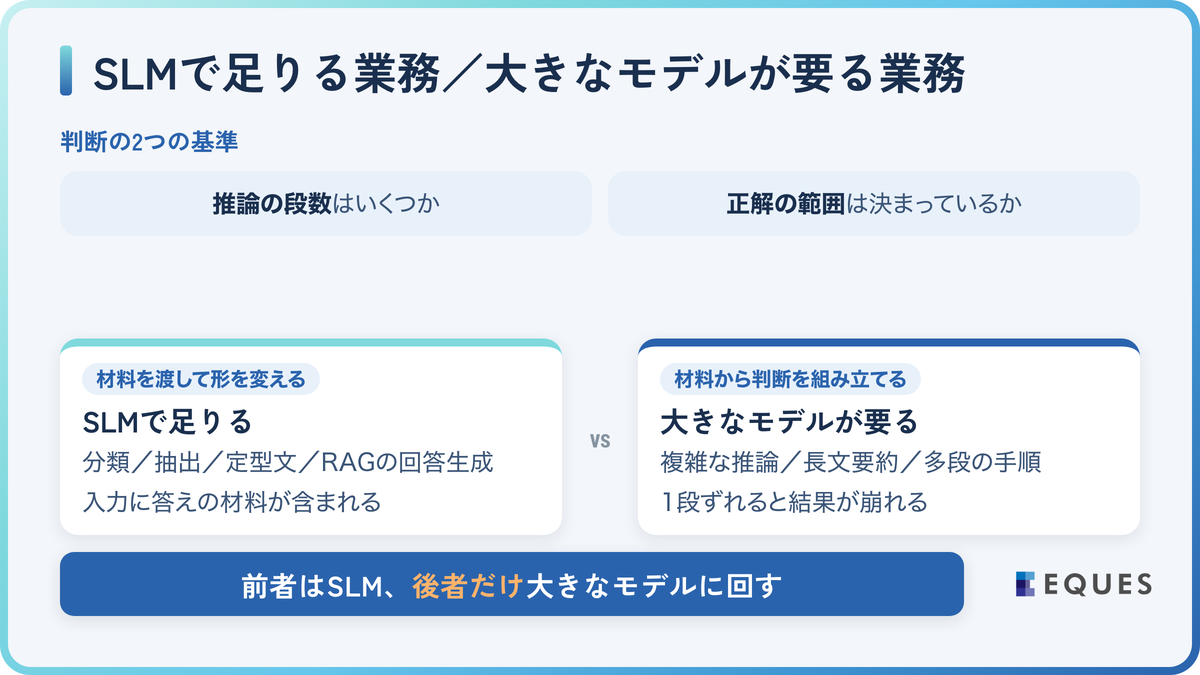
選ぶ基準は「タスクの中に推論の段数がいくつあるか」と「正解の範囲が決まっているか」の2点に集約できます。段数が少なく正解の範囲が定まる業務ほどSLMで足り、段数が多く答えが開いている業務ほど大きなモデルが要ります。
モデルの規模が物を言うのは、内部に蓄えた知識の量と多段の推論の安定性です。例えば帳票の項目抽出は項目名が揃えば小型でも安定しますが、契約書の条件突き合わせでは小型が1条件を見落としがちです。
SLMで足りる業務:分類・抽出・定型文・RAGの回答生成
SLMで足りる代表は、問い合わせの分類、帳票からの項目抽出、定型文の生成、RAG(=文書を検索し、その内容を根拠に答えさせる仕組み)の回答生成です。いずれも入力に答えの材料が含まれ、モデルが補う知識が少ないため、「読んで形を変える」処理は小さなモデルでも安定します。
例えば社内規程のRAGでは、検索で該当箇所を取り出し、SLMがそれを根拠に回答文を組み立てます。回答の質を左右するのは検索の精度であり、生成側を大きくしても検索が外れていれば答えは直りません。
大きなモデルが要る業務:複雑な推論・長文要約・多段の手順
大きなモデルが要るのは、複数の条件を突き合わせる判断、数十ページに及ぶ長文の要約、手順を自分で組み立てる多段のタスクです。途中の推論が1段ずれると最終結果が崩れるため、規模による安定性の差がそのまま出ます。
迷うときは、業務を「材料を渡して形を変える工程」と「材料から判断を組み立てる工程」に分けます。前者をSLM、後者だけを大きなモデルに回す分担にすると、機密データを手元に置いたまま費用も抑えられます。
代表的なSLM5選と日本語性能の目安
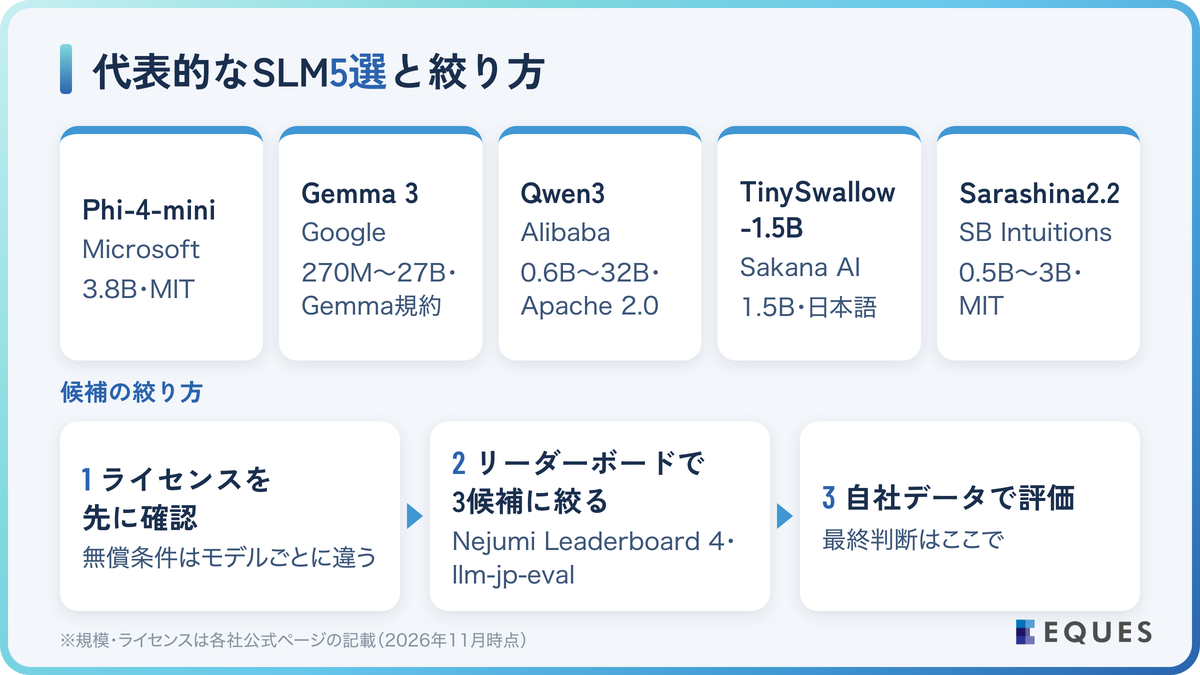
公式ページで確認できる規模・ライセンス・用途だけを示し、評価条件の揃わないベンチマークの数値は載せません。日本語性能は公開リーダーボードで候補を絞り、最後は自社データで測るのが堅実です。
1. Microsoft Phi-4-mini(3.8B・MITライセンス)
MicrosoftのPhi-4-miniは、38億パラメータで、文脈長(=一度に読み込める入力の長さ)は12万8千トークンです。対応言語に日本語が明記されており、推論と関数呼び出しに対応し、メモリや計算資源が限られる環境を主な用途としています。
上位の14BモデルPhi-4は英語主体ですが同じMITなので、規模を上げてもライセンスの確認をやり直さずに済みます。
2. Google Gemma 3(270M〜27B・Gemma利用規約)
GoogleのGemma 3は2億7千万・10億・40億・120億・270億の5サイズで、140以上の言語に対応します。4B以上は画像入力にも対応し、文脈長は4B以上で12万8千トークンです。
1つの系列で規模を選べるため、同じ構成のままSLMから中規模へ移行しやすいのが利点です。後継のGemma 4(E2B・E4B・12B・26B A4B・31Bの5サイズ、Apache 2.0)も公開されています。
3. Alibaba Qwen3の小型モデル(0.6B〜32B・Apache 2.0)
AlibabaのQwen3は、0.6B・1.7B・4B・8B・14B・32Bの密なモデル(=全パラメータを毎回使う構造)がApache 2.0で提供され、119の言語と方言に対応します。後継のQwen3.5も4B・9BがApache 2.0で公開されています。
段階的に考える「思考モード」と即答する「非思考モード」を1つのモデルで切り替えられる点が特徴で、分類と推論が混在する業務でもモデルを2つ運用せずに済みます。
4. Sakana AI TinySwallow-1.5B(日本語・15億パラメータ)
Sakana AIのTinySwallow-1.5Bは、320億パラメータの教師モデルから知識蒸留(=大きなモデルの知識を小さなモデルに写す学習法)の新手法TAIDで知識を移した日本語モデルです。
同規模(3B未満)の日本語ベンチマークで最高性能と同社は説明し、iPhoneやブラウザでオフライン動作するデモを示しており、端末上で完結する処理を試す入口になります。
5. SB Intuitions Sarashina2.2(0.5B/1B/3B・MIT)
ソフトバンク子会社のSB Intuitionsが公開したSarashina2.2は、0.5B・1B・3Bの3サイズに事前学習版と指示学習版があります。
日本語を中心に学習した国産の小型モデルで、商用利用の制約が少ないため、国内企業が社内文書を扱う検証で最初に試しやすい選択肢です。
MetaのLlama 3.2(1B・3B)は公式の対応言語一覧に日本語が含まれず、Mistral AIのMinistral 3B・8Bは研究用途を除き、自社環境での商用利用に商用ライセンス契約が必要です。
無償で使える条件はモデルごとに異なるため、ライセンスの確認を候補選びの最初に行います。後回しにすると、PoCの後で商用契約や再配布の条件が判明し、本番直前にモデルを選び直すことになります。
日本語性能の目安は、Weights & Biasesの公開リーダーボード「Nejumi Leaderboard 4」と、国立情報学研究所のLLM研究開発センターが主宰するLLM-jpの評価ツールllm-jp-evalで確認します。
評価データの分野や文体が自社の入力と違えば正答率が動くため、リーダーボードは候補を3つ程度に絞る道具にとどめ、最終判断は自社の入力データでの評価に委ねます。
日本語モデルの詳しい比較は「ローカルLLMの日本語モデル比較|業務向け7選と選び方2026」、国産モデルの全体像は「国産LLMとは?」で解説しています。
参照元:Microsoft「Phi-4-mini-instruct」(2025年2月)、「phi-4」(2024年12月)/Google「Gemma 3 model card」(2025年)/Google「Gemma 4 model card」/Alibaba「Qwen3」(2025年4月)/Alibaba「Qwen3.5-9B」/Meta「Llama-3.2-3B-Instruct」(2024年9月)/Mistral AI「Ministraux」(2024年10月)/Sakana AI「TinySwallow-1.5B」(2025年1月)/SB Intuitions「sarashina2.2-3b-instruct-v0.1」(2025年)/LLM-jp「リリース一覧」/Weights & Biases Japan「Nejumi Leaderboard 4」
業務でSLMを使うときの進め方:PoCから本番までの3ステップ
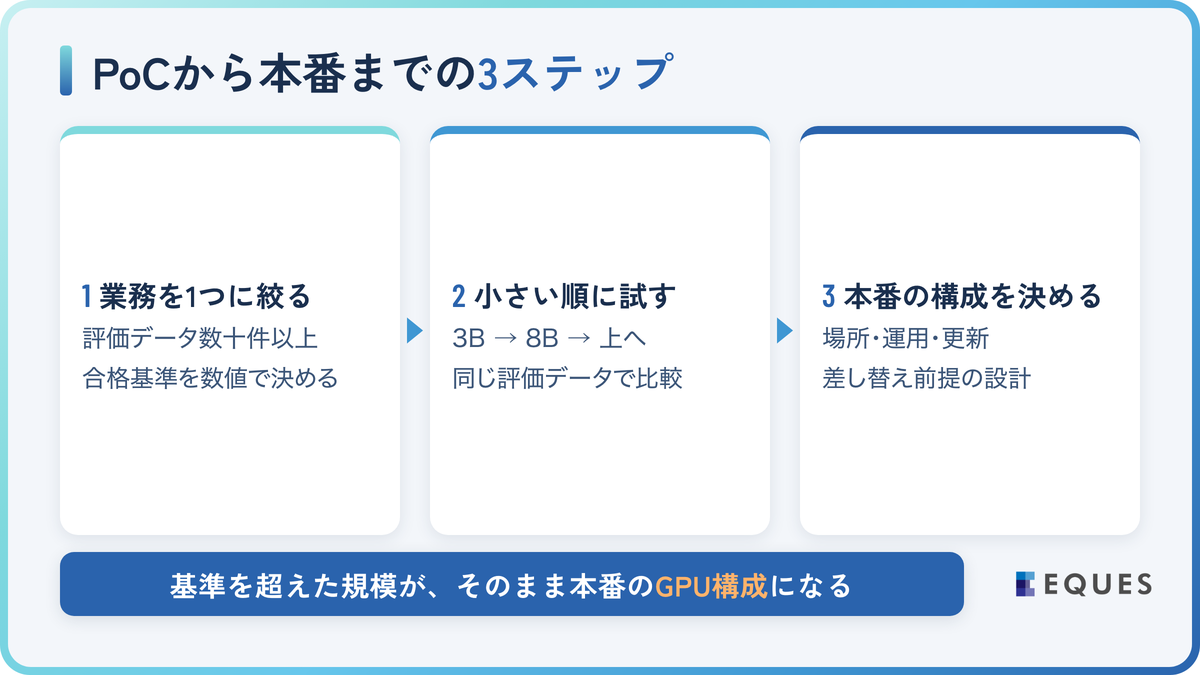
小さく試し、同じ評価データで測り、それから本番の構成を決める3ステップで進めると、必要以上の機材投資と「動いたが使えない」結果の両方を避けられます。
1. 業務を1つに絞り、評価データと合格基準を先に決める
最初に対象業務を1つに絞り、実際の入力と期待する出力の組を数十件以上用意し、合格基準(正答率・処理時間・確認の工数)を数値で決めます。評価データがないままモデルを触り始めると「なんとなく良い」で終わり、本番の判断に進めません。
2. 小さいモデルから順に試し、同じ評価データで比較する
3B前後のSLMで合格基準に届けば機材も費用も最小で済み、届かなければ8B、さらに上の規模へ上げます。「どの規模で基準を超えたか」を記録しておくと、本番のGPU構成がそのまま決まります。
3. 本番の構成(場所・運用・更新)を決めて移行する
規模が決まったら、動かす場所(社内サーバーか、クラウド上の自社専用環境か)、監視と更新の担当、モデルの差し替え手順を決めて本番に移します。SLMはモデルの世代交代が速いため、差し替え前提の設計にしておくと、新しいモデルを大きな費用をかけずに取り込めます。
PoCの期間設定や失敗を防ぐ要点は「AI PoCの進め方とは?期間や失敗しない秘訣を事例と共に解説」で整理しています。
このように、SLMとLLMの選択は業務を絞った小さな検証で決まります。この段階を支援するため、弊社はAI PoCサービス「ココロミ」(スリムプラン月々99万円〜・スタンダードプラン月々250万円〜)を提供しています。
東北電力の事業創出部門とは、部門のフォーマットに合わせた専用のスライド生成AIを研究段階で開発し、SOLIZE PARTNERS株式会社とは設計ナレッジの提案支援と3D CADデータの自動生成の2テーマをPoCで検証しました。
参照元:株式会社EQUES「東北電力 部門専用スライド生成AIの研究」、「SOLIZE PARTNERS株式会社 導入事例」
ローカルLLMとSLMの違いに関するよくある質問
Q. SLMとローカルLLMは同じものですか?
同じではありません。SLMは規模、ローカルLLMは動かす場所の呼び名で、クラウドで動かすSLMも存在します。
Q. SLMの精度はLLMに比べてどの程度劣りますか?
入力に材料が揃う分類・抽出・RAGの回答生成では差が小さく、多段の推論や長文の要約では大きく出ます。
Q. 社内サーバーでSLMを動かすには、どの程度のGPUが必要ですか?
3B〜8Bのモデルなら、24GB級の業務用GPU1枚が検証の出発点です。
Q. SLMの商用利用でライセンス上の注意点はありますか?
MITやApache 2.0のモデルは制約が少ない一方、本文で挙げたLlama・Ministralのように無償で使えない条件のモデルもあり、モデルごとの確認が要ります。
まとめ
要点は次のとおりです。
- SLMは数億〜数十億パラメータという規模の分類、ローカルLLMは自社環境で動かすという場所の分類である
- 入力に答えの材料が揃う分類・抽出・定型文・RAGの回答生成はSLMで足り、多段の推論や長文の要約は大きなモデルが向く
- 小さいモデルから順に同じ評価データで試し、基準を超えた規模で本番のGPU構成を決める
自社の業務がSLMで足りるかを確かめる段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
SLMかLLMか、小さな検証で決めませんか
AI PoCサービス「ココロミ」は、業務を絞った検証でモデル選定の根拠を作ります。まずは無料相談からどうぞ。