記事の要約
- ローカルLLMの日本語モデルとは、社内のPCやサーバーで動かせる公開モデルのうち日本語に対応したもののことで、国産の独自開発、日本語の追加学習、海外の多言語の3系統があります。
- 日本語性能は公開ベンチマーク(=性能を測る共通の試験)で目安がつきますが、尺度や測定時期が評価ごとに違うため、点数は候補の絞り込みに使い、最終判断は自社の文書で行います。
- モデル本体のメモリは規模と量子化(=数値を粗くして軽くする処理)で決まり、Gemma 4の最大サイズも4ビットなら約17.5GBで、文章が長いほど上乗せが要ります。
「機密文書を扱うのでローカルLLMを使いたいが、日本語で実用になるモデルが分からない」。情シスや開発の責任者からよく聞く悩みです。日本語の自然さはモデルによって差が大きく、英語中心の評価だけでは選べません。
本記事では、ローカルLLMの日本語モデルを7つ比較し、日本語性能の見方、用途別の選び方、必要なGPUメモリの目安を解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業の生成AI開発やローカルLLM開発を手がける弊社が、選定で見ている観点で整理しました。読み終えたとき、自社に合う候補を2〜3個に絞れることがゴールです。
目次
ローカルLLMの日本語モデルとは?3つの系統と比較の前提
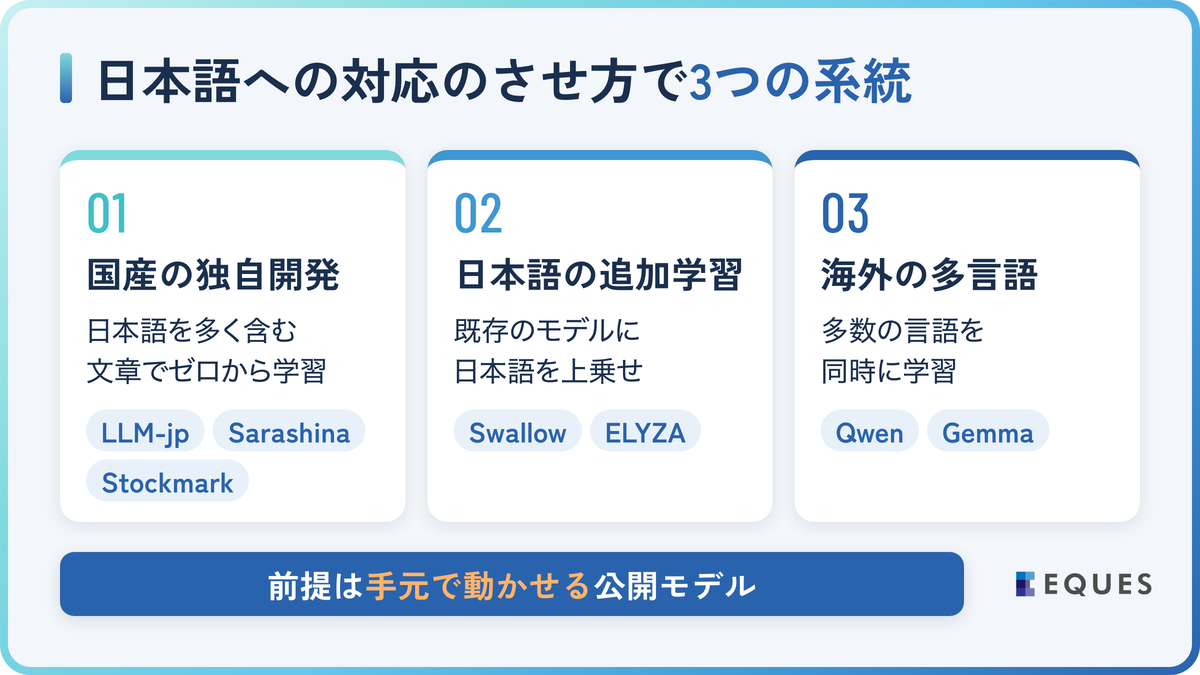
ローカルLLMの日本語モデルとは、社内のPCやサーバーで動かせて、日本語の学習や評価が公表されているモデルのことです。前提は、オープンウェイト(=モデル本体のデータが公開され、手元で動かせる形)であることです。
日本語への対応のさせ方で、モデルは3つの系統に分かれます。系統ごとに日本語の強さの出どころが違うため、最初に見分けておきます。
- 国産の独自開発:日本語を多く含む文章でゼロから学習(LLM-jp、Sarashina、Stockmark)
- 日本語の追加学習:既存のモデルに日本語を上乗せ(Swallow、ELYZA)
- 海外の多言語モデル:多数の言語を同時に学習(Qwen、Gemma)
規模はパラメータ(=モデル内部の数値の数)で表し、「8B」は80億個です。規模が大きいほど賢くなる傾向がある一方、必要なメモリも増えます。
モデル本体を公開していないtsuzumi 2(NTT)などは対象外とし、国産LLMの政策面は「国産LLMとは?政府が選んだ7モデル比較と導入の判断基準」に譲ります。
ローカルLLMの日本語性能の見方|ベンチマークとモデルカードの読み方
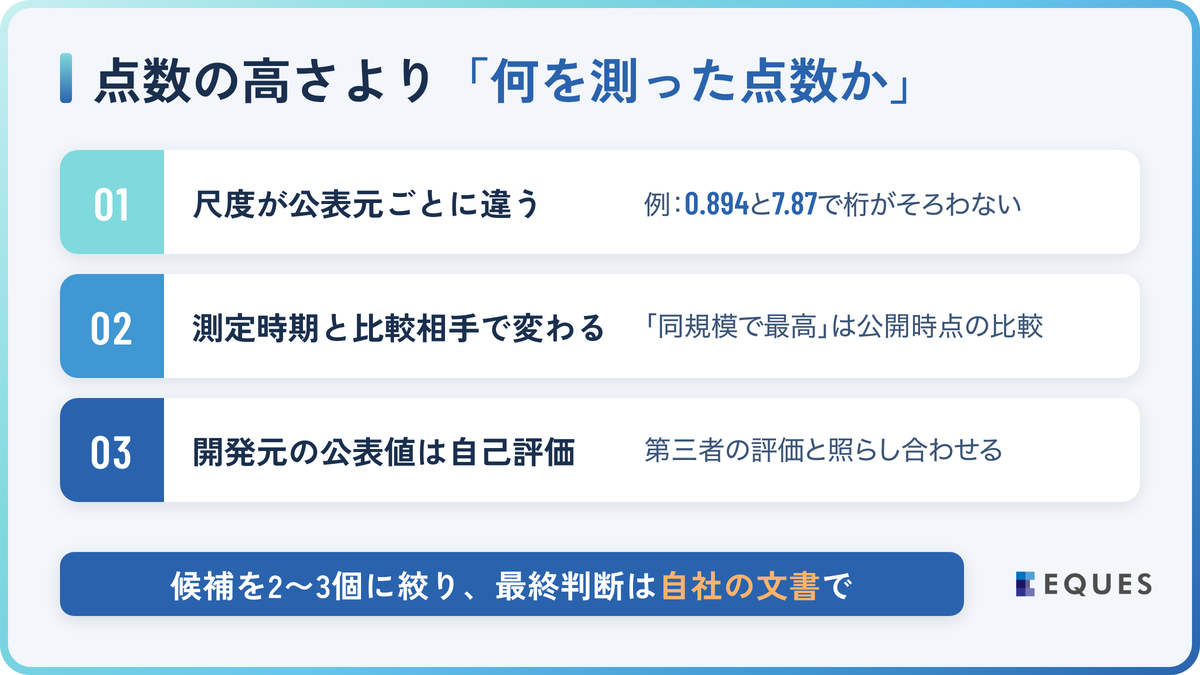
日本語性能は、公開ベンチマークの点数と、開発元のモデルカード(=仕様や評価結果を記した公式の説明書)で確かめます。大事なのは点数の高さより「何を測った点数か」です。
| 評価(運営) | 何を測るか |
|---|---|
| JGLUE(ヤフー・早稲田大学) | 文の分類や読解など日本語理解の基礎(自動採点) |
| Japanese MT-Bench(Stability AI) | 執筆・推論など8分野の自由記述(審査役のAIが10点満点で採点) |
| Nejumi LLMリーダーボード4(Weights & Biases Japan) | 翻訳・推論・コードなどの汎用言語性能と、指示の順守・安全性など、人の意図に沿う度合い |
| Swallow LLM Leaderboard v2(東京科学大学・産業技術総合研究所(産総研)) | 質問応答・翻訳・数学・コードなど高難度の日本語課題 |
点数を読むときの注意は3つです。第1に、尺度が公表元ごとに違います。同じ日本語MT-Benchでも、Qwen3 Swallow 32Bの公表値は0.894、ストックマークは7.87と桁がそろっていません。
第2に、測定時期と比較相手で順位が変わります。「同規模で最高」は公開時点の比較で、数か月で塗り替わります。
第3に、開発元の公表値は自己評価です。条件を開発元が選んでいるため、第三者の評価と照らし合わせます。
そのため、ベンチマークは候補を2〜3個に絞る一次選別に使い、最終判断は自社の文書で行うのが現実的です。
参照元:Swallowプロジェクト「Qwen3 Swallow」(2026年2月20日)、ストックマーク「Stockmark-2-100B-Instruct」(2026年10月12日確認)
ローカルLLMの日本語モデル7選の比較表【2026年10月12日確認】
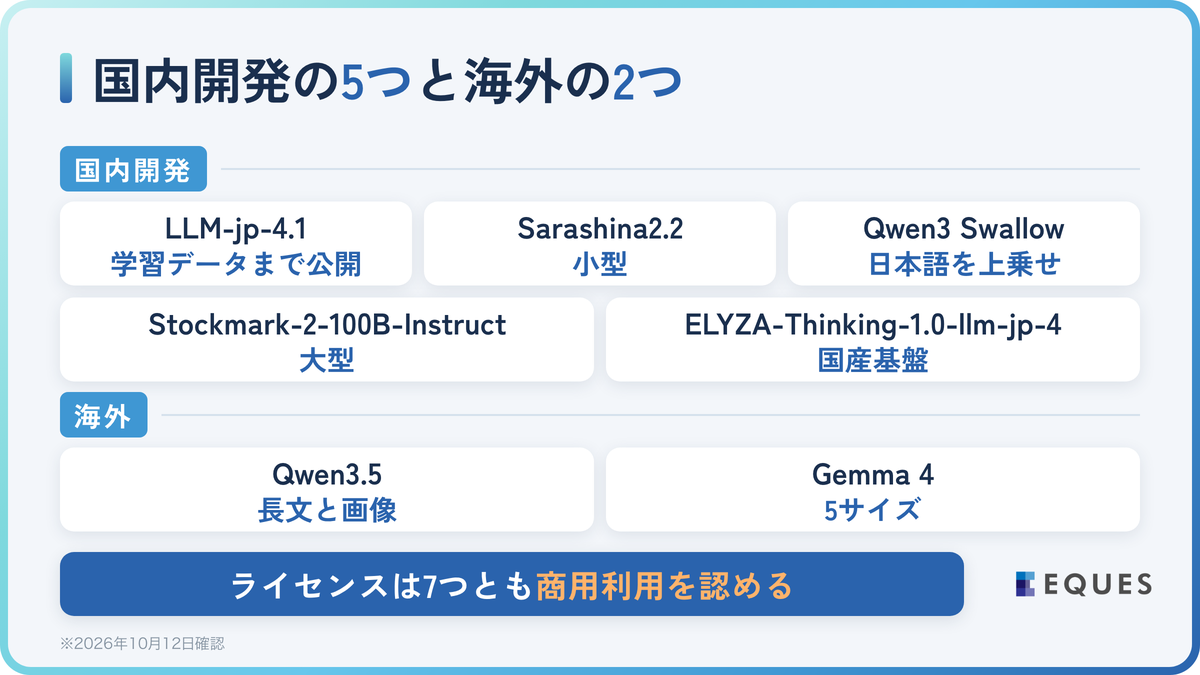
国内開発の5つと海外の2つを公式情報で確認しました。メモリの目安は4ビット量子化時のモデル本体の計算値で、実際には会話の長さなどに応じたメモリが加わります。
サイズの「32B-A3B」は、MoE(=複数の専門部分を切り替えて使う構造)で総数32Bのうち一度に動かすのが3B分という意味です。
| モデル(公開元) | 日本語の学習 | 主なサイズ | 4ビット時の目安 | 向く用途 | ライセンス |
|---|---|---|---|---|---|
| LLM-jp-4.1(国立情報学研究所) | ゼロから学習 | 8B/32B-A3B/33B | 約4〜17GB | データの説明が要る業務・推論 | Apache 2.0 |
| Sarashina2.2(SB Intuitions) | ゼロから学習 | 0.5B/1B/3B | 約0.4〜1.7GB | 端末での定型作業 | MIT |
| Stockmark-2-100B-Instruct(ストックマーク) | ゼロから学習 | 96B | 約48GB | サーバーでの対話・文書作成 | MIT |
| Qwen3 Swallow(東京科学大学・産総研) | 海外モデルに追加学習 | 8B/30B-A3B/32B | 約4〜16GB | 英日翻訳・推論 | Apache 2.0 |
| ELYZA-Thinking-1.0-llm-jp-4(ELYZA) | 国産モデルに追加学習 | 32B-A3B/33B | 約16〜17GB | 指示の順守・日本の知識 | Apache 2.0 |
| Qwen3.5(Alibaba Cloud) | 多言語(201の言語・方言) | 0.8B〜397B-A17B | 27Bで約14GB | 長文・画像を含む資料 | Apache 2.0 |
| Gemma 4(Google DeepMind) | 多言語(140超の言語で学習) | E2B〜31Bの5種 | 約2.9〜17.5GB(公式値) | PCでの汎用用途・画像入力 | Apache 2.0 |
ライセンスは7つとも商用利用を認める標準型です。表示義務などの読み方は「ローカルLLMの商用利用|ライセンスの見方と8モデル比較2026」に譲ります。
1. LLM-jp-4.1:学習データまで公開された国産モデル
国立情報学研究所が2026年9月に公開した、約11.7兆トークン(=AIが文章を処理する単位)でゼロから学習したモデルです。学習に使った文章の大半が公開されているため、データの出どころを説明する必要がある業務に向きます。
答える前に考える過程を経る推論型として調整され、外部ツールを呼び出す力の日本語での評価も公表されています。
2. Sarashina2.2:小さなメモリで動く小型モデル
SB Intuitionsが公開した0.5B〜3Bの小型モデルで、日本語・英語・コードを含む10兆トークンを土台に学習しています。3Bでも4ビットならモデル本体は約1.7GBです。
手元の端末で定型文の作成や分類を試す入口に向きます。3Bの日本語MT-Benchは6.51で、比較した同規模のモデルを上回ったと公表されています。
3. Stockmark-2-100B-Instruct:日本語を重視した大型モデル
ストックマークが日本語を重視してゼロから学習した、約1,000億パラメータのモデルです。学習データの3割が日本語で、日本語の合成データ(=人工的に作った学習用データ)で指示への応じ方を調整しています。
4ビットでも計算上約48GBとGPUサーバー向けの規模です。3.2万トークンまでの文脈(=一度に読み込める入力の範囲)を扱え、日本語MT-Benchの平均は7.87と公表されています。
4. Qwen3 Swallow:海外モデルに日本語を上乗せ
東京科学大学と産総研が2026年2月に公開した、AlibabaのQwen3に日本語を追加学習したモデルです。日本語の知識と英日翻訳を強め、数学やコードの力は維持か改善を目指したと公表されています。
32Bは、公開時点で32B以下のオープンなLLMの中で日本語課題の平均が最も高かったとされます。4ビット量子化済みの版も公式に配布されています。
5. ELYZA-Thinking-1.0-llm-jp-4:国産基盤の推論型モデル
ELYZAが2026年10月に公開した、国産のLLM-jp-4を土台とする推論型のモデルです。土台の学習から追加学習まで国内で行われた点が特徴です。日本語の推論、条件つきの指示の順守、日本語の知識を重点的に強化しています。
6. Qwen3.5:長文と画像に強い多言語モデル
Alibaba Cloudの多言語モデルで、201の言語・方言に対応し、0.8Bから397B-A17Bまで規模を選べます。標準で約26万トークンの長い文脈を扱え、画像を含む資料の読み取りにも対応します。
Qwen3.5の設計を土台にしたQwen3.8-27B(2026年8月)もApache 2.0で公開されており、乗り換えの候補になります。
7. Gemma 4:端末からワークステーションまで5サイズ
Google DeepMindが2026年3月末に公開したモデル(12Bは6月に追加)で、140を超える言語のデータで学習されています。E2B・E4B(=実効20億・40億規模の小型版)は端末向け、12B〜31BはGPU搭載PCやワークステーション向けに設計されています。ワークステーションは高性能な業務用PCのことです。
参照元:国立情報学研究所 LLM-jp「LLM-jp-4.1 モデルの公開」(2026年9月28日)、Google「Gemma 4: Expanding the Gemmaverse with Apache 2.0」(2026年4月2日)、Google「Gemma releases」(リリース履歴)、各モデルの公式モデルカード(表のモデル名にリンク)
用途別の選び方|自社に合う日本語モデルの絞り込み方
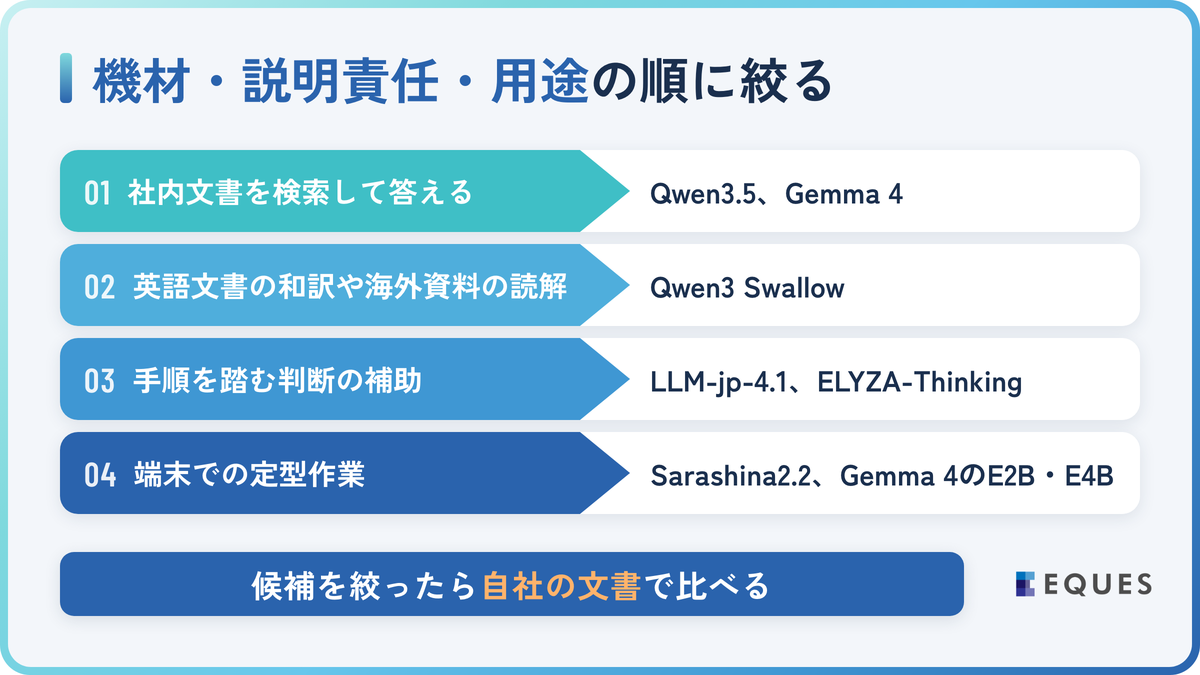
日本語モデルは「一番賢いもの」ではなく、動かす機材、説明責任、用途の順に絞ると決めやすくなります。機材で規模の上限が、説明責任で国産を条件にするかが決まるためです。
- 社内文書を検索して答えるRAG(=文書を検索し、その内容を根拠に答えさせる仕組み):長文に強いQwen3.5、Gemma 4
- 英語文書の和訳や海外資料の読解:英日翻訳を強化したQwen3 Swallow
- 手順を踏む判断の補助:推論型のLLM-jp-4.1、ELYZA-Thinking
- 端末での定型作業:Sarashina2.2、Gemma 4のE2B・E4B
候補を絞ったら自社の文書で比べます。実際の問い合わせから正解の分かる質問を30〜50件選び、量子化・指示文・参照文書をそろえて候補ごとに回答を集めます。
採点は審査役のAIに任せきりにせず、業務担当者が正確さと社内用語の扱いを確かめます。1回答あたりの時間とメモリ使用量も記録すると、機材の見積もりに使えます。
ローカルLLMの日本語モデルに必要なスペック|量子化とGPUメモリ
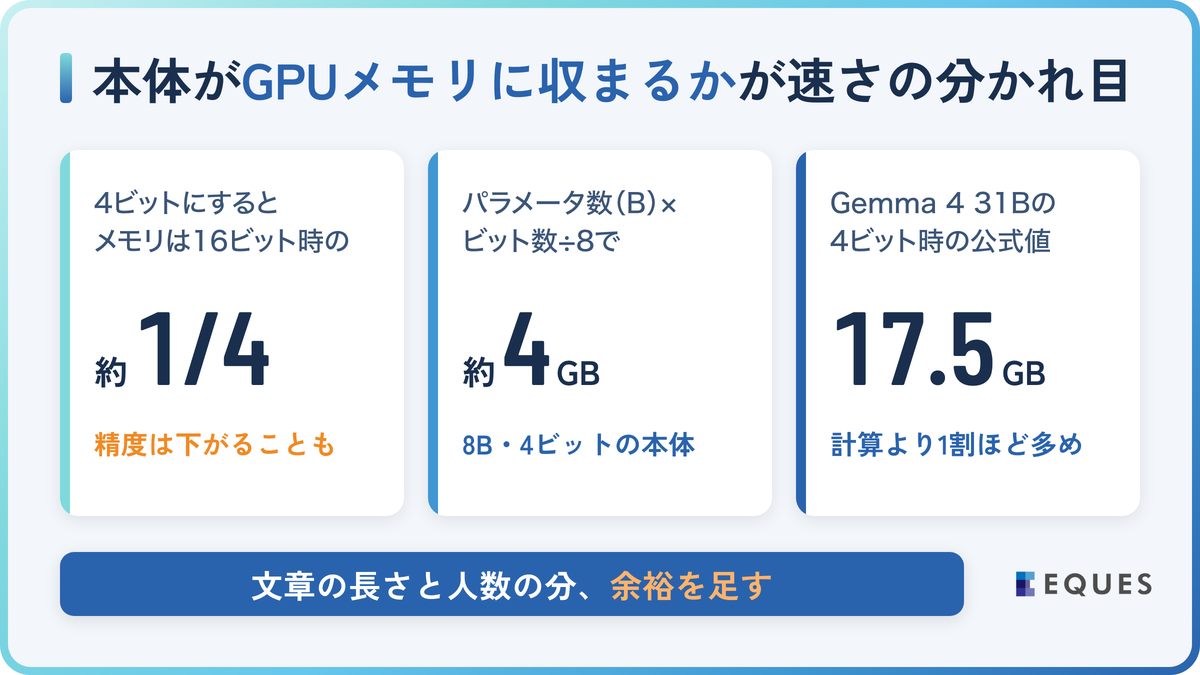
必要なスペックの決め手は、GPUのVRAM(=GPUに搭載された専用メモリ)の容量です。モデル本体がVRAMに収まるかどうかが、実用的な速さで動くかの分かれ目になります。
量子化で数値を16ビットから4ビットに粗くすると、必要なメモリは16ビット時のおよそ4分の1になる一方、精度は下がることがあります。Gemma 4の公式値は次のとおりです。
| モデル | 16ビット | 4ビット |
|---|---|---|
| Gemma 4 E4B | 17.9GB | 4.5GB |
| Gemma 4 12B | 26.7GB | 6.7GB |
| Gemma 4 26B A4B | 57.7GB | 14.4GB |
| Gemma 4 31B | 69.9GB | 17.5GB |
他のモデルは「パラメータ数(B)×ビット数÷8」で本体の大きさ(GB)を見積もれ、8Bの4ビットで約4GBです。Gemma 4の12B〜31Bの公式値は、この計算より1割ほど多めです。
表の値は本体の分だけで、入力と出力の文章が長いほどメモリは増えます。MoEの26B A4Bも、動かす部分は4B分ですが、全体をメモリに載せる必要があります。
同時に使う人数が増えると扱う文脈も増えるため、目安に余裕を足してGPUを選びます。
PCの構成例は「ローカルLLMとは?仕組みとメリット・必要なPCスペック2026」で解説しています。
参照元:Google「Gemma 4 model overview」(2026年7月8日更新)、Ollama「FAQ」(2026年10月12日確認)
このように、日本語モデルの選定は評価の読み方と機材の見積もりが絡み、社内だけでは判断材料が揃いにくい作業です。
弊社は、AI・DXの疑問を東大出身のAI専門家にチャットで相談できる「AI×DX寺子屋」(プランA=月額20万円・税抜で相談し放題)を提供しています。
候補モデルを自社データで本格的に比べる段階なら、AI PoC(=本番開発の前に小さく行う技術検証)サービス「ココロミ」でもご一緒できます。
ローカルLLMの日本語モデルに関するよくある質問
国産であること自体が、日本語性能の高さを意味するわけではありません。ELYZAのモデルカードでも、日本語評価の平均はGemma 4 31Bが国産基盤の同社モデルを上回るため、用途と説明責任で選びます。学習データの出どころを説明したいなら、データを公開しているLLM-jpが候補です。
小型モデルならCPUでも動きますが、応答は遅くなります。4ビットで数GBに収まるSarashina2.2やGemma 4のE4Bから試し、複数人で使うならGPUを前提にします。
まずはRAGで社内文書を参照させ、足りるかを確かめるのが一般的です。ファインチューニング(=既存モデルを自社データで追加学習すること)は、書式や言い回しをそろえたいときに検討します。
本記事の7モデルでも、2026年に入って複数の新版が出ています。半年ごとに候補を見直し、同じ評価用の質問で新旧を比べると、乗り換えを判断しやすくなります。
まとめ
ローカルLLMの日本語モデルは、ベンチマークの順位だけで選ばず、機材・説明責任・用途で2〜3個に絞り、自社の文書で確かめるのが近道です。要点は次のとおりです。
- 日本語モデルは国産の独自開発、日本語の追加学習、海外の多言語の3系統
- ベンチマークは尺度・時期・自己評価に注意し、一次選別に使う
- 必要メモリは「パラメータ数×ビット数÷8」に、文脈と同時利用の分を足す
日本語モデルの候補選びや評価の設計で迷われている段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
日本語モデルの選定をチャットで相談しませんか
AI×DX寺子屋では、モデル選定や必要スペックの疑問を東大出身のAI専門家にチャットで相談できます。まずは無料相談からどうぞ。