記事の要約
- 国産LLMとは、国内の企業や研究機関が開発した大規模言語モデルのことで、ゼロから開発したものと海外モデルを基に日本語へ最適化したものに分かれます。
- デジタル庁が2026年3月に7つの国内開発モデルを選んだ際の公募条件は、学習データの適法性や安全性の評価など、企業の判断基準としても使えます。
- 汎用のモデルは自社固有の知識を持たないため、社内文書を参照させる仕組みや業務特化の設計と組み合わせる必要があります。
「社外にデータを出せないため海外のクラウドAIは使えない。かといって、国産LLMは種類が多くて何を基準に選べばよいのか分からない」。情報システム部門で検討が止まる典型的な理由です。比較記事は数多くありますが、性能の順位づけだけでは自社に適したモデルは決まりません。
本記事では、国産LLMの定義と開発の方式を整理したうえで、2026年3月にデジタル庁が政府利用に向けて選定した7モデルを一覧で紹介します。あわせて、その選定で実際に用いられた条件を、そのまま企業が使えるチェック項目として読み替えます。
目次
国産LLMとは?海外モデルとの違いと2つの開発アプローチ
国産LLMとは、国内の企業や研究機関が開発した大規模言語モデルを指します。海外の主要モデルとの違いは、性能そのものよりも、日本語の語彙や表現への適合と、データの取り扱いを国内の枠組みで完結させやすい点にあります。
日本語には敬語表現や主語の省略、同音異義語といった特徴があり、業務文書では独特の記述様式も使われます。こうした言語的な特性への対応が、国産LLMが注目される出発点です。言語モデルは学習データに多い言い回しほど再現しやすいため、日本語を多く学んだモデルほど主語の補い方や敬語の段階を外しにくくなります。
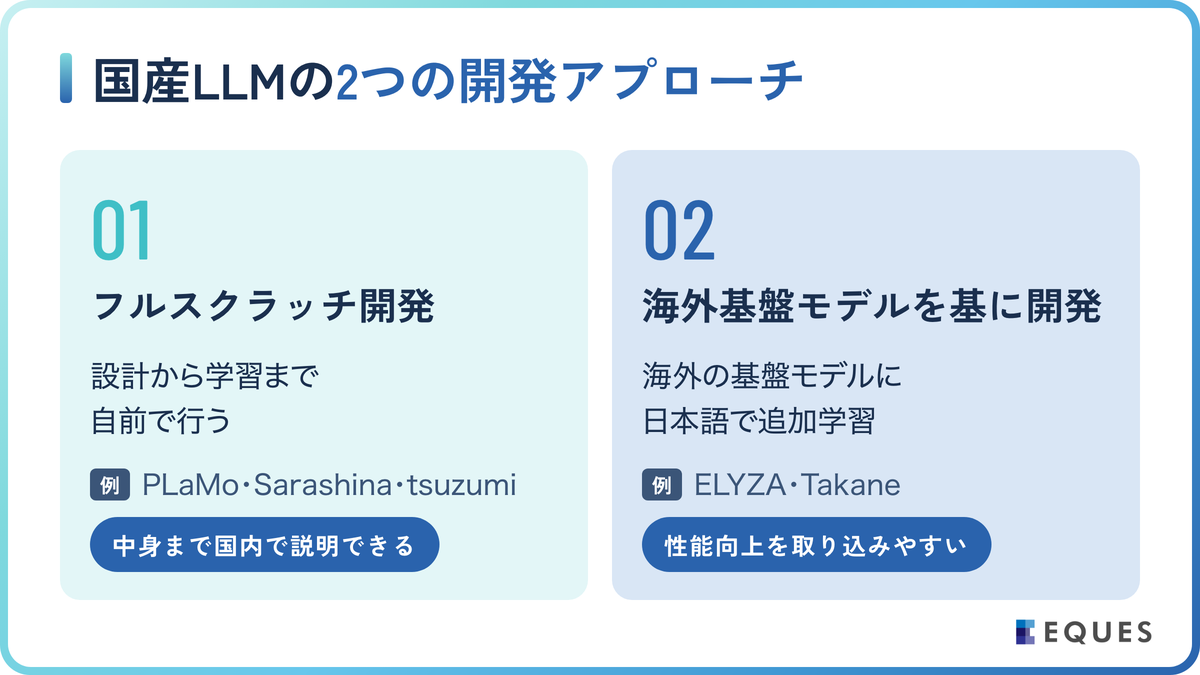
開発の方式は大きく2つに分かれます。ひとつは、設計から学習までを自前で行うフルスクラッチ開発です。
Preferred Networksの「PLaMo」やソフトバンク系の「Sarashina」、NTTの「tsuzumi」がこの方式にあたります。学習データと手順を開発元が把握しているぶん、出力の癖を説明しやすい方式です。
もうひとつが、海外で公開されている基盤モデルを土台に、日本語データで追加学習を行う方式です。ELYZAがMetaの「Llama」を基に開発したモデルや、富士通がCohereのモデルを土台とした「Takane」が該当します。
どちらが優れているという話ではなく、前者は言語モデルの中身まで国内で説明できる点、後者は世界的な性能向上の成果を取り込みやすい点にそれぞれの利点があります。自社が重視するのが説明可能性なのか、性能の伸びなのかで見方が変わります。
なぜ企業が国産LLMを求めるのか|3つの理由
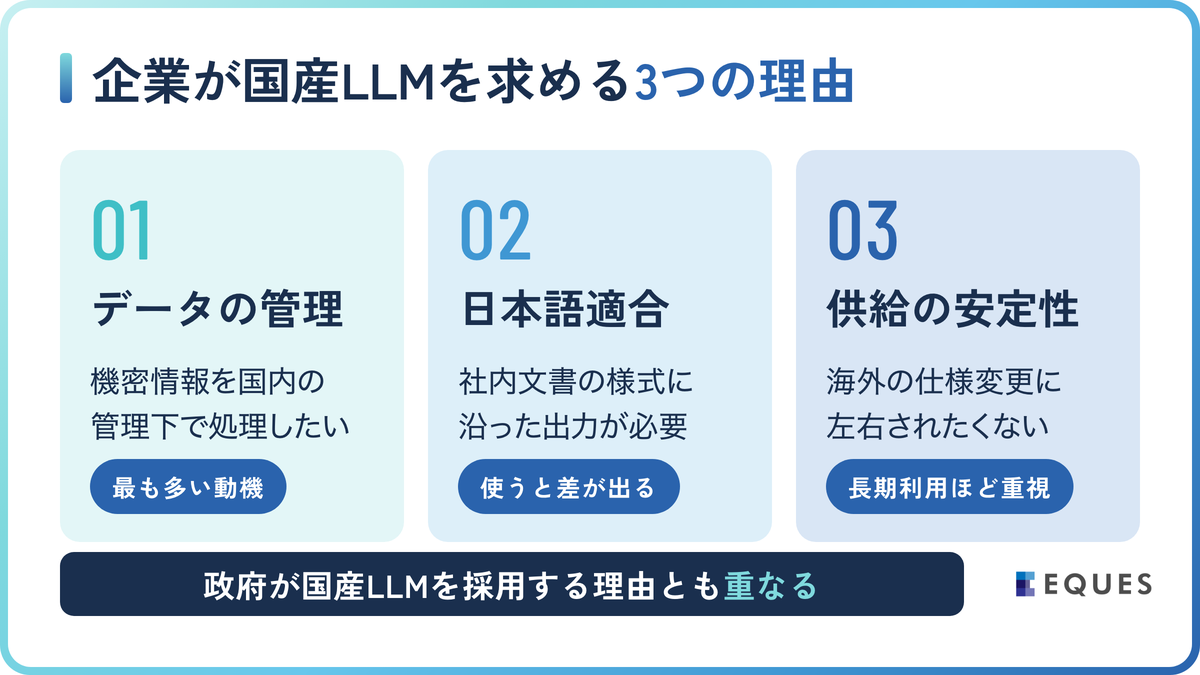
企業が国産LLMを検討する理由は、単なる国産志向ではありません。実務上の要請として、次の3点に整理できます。
- データの越境と管理:機密情報を国内の管理下で処理したい
- 日本語と業務文書への適合:社内文書の様式に沿った出力が必要
- 供給の安定性:海外サービスの仕様変更や提供条件に左右されたくない
1つ目の動機はデータの取り扱いです。個人情報や取引先の機密を含む文書を扱う場合、どこで処理され、入力内容が学習に使われないかを説明できる必要があります。説明できないと利用が認められず、現場が個別に外部サービスへ入力する抜け道が生まれます。
2つ目の日本語適合は、実際に使うと差が出る部分です。海外モデルの日本語能力は年々向上していますが、行政文書や社内規程のような定型の様式に沿った出力では、日本語データで学習したモデルが安定する場面があります。
様式の決まった文書ほど、その様式を学習したかどうかが出力に表れるためです。項目名や文末の形が崩れると、人が直す手間が残ります。
3つ目の供給の安定性は、長期利用を前提とする企業ほど重視する観点です。基幹業務に組み込んだ後にサービスの提供条件が変わると、移行に大きな負担が生じます。作り込んだ指示文や後工程を、別のモデル向けに作り直すことになるためです。
この3点は、政府が国産LLMを採用する理由とも重なります。デジタル庁は、ガバメントAIには日本語の語彙・表現に適合し、日本の文化・価値観を尊重した国産LLMの活用が不可欠だとして、2025年12月2日から2026年1月31日を期限に国内開発LLMの公募を実施しました。
国内企業や研究機関が開発するAIモデルを政府が積極的に活用することで、信頼できるAIの国内開発を支援するという方針です。社内の決裁で、なぜこのモデルかを説明する材料にもなります。
【2026年版】政府が選定した国産LLM7モデル一覧
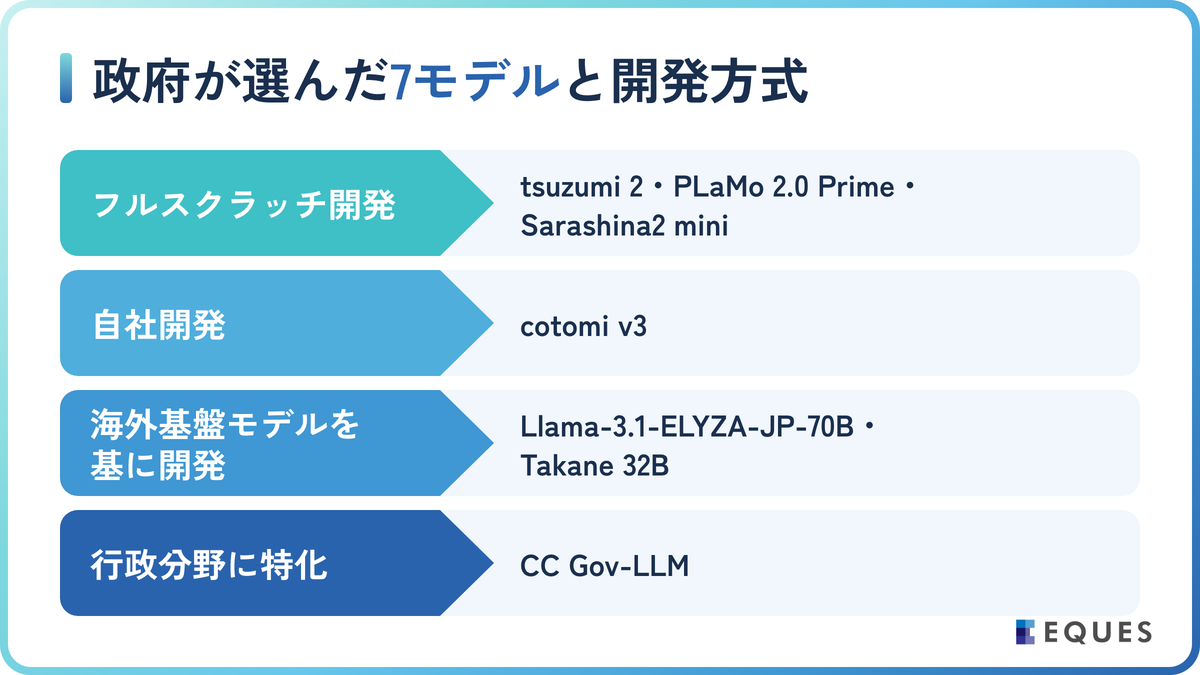
デジタル庁は2026年3月6日、生成AI利用環境「源内」で試験的に利用する国内開発LLMの選定結果を公表しました。15件の応募のうち、書類審査と評価テストを経て選定されたのは7件です。企業が候補を検討する際の出発点として、実用に足るかどうかを公的機関が確認した一覧は有用です。
| モデル名 | 開発・提供 | 開発の方式 |
|---|---|---|
| tsuzumi 2 | 株式会社NTTデータ | フルスクラッチ開発 |
| PLaMo 2.0 Prime | 株式会社Preferred Networks | フルスクラッチ開発 |
| Sarashina2 mini | ソフトバンク株式会社 | フルスクラッチ開発 |
| cotomi v3 | 日本電気株式会社(NEC) | 自社開発 |
| Llama-3.1-ELYZA-JP-70B | KDDI株式会社・株式会社ELYZA | 海外基盤モデルを基に開発 |
| Takane 32B | 富士通株式会社 | 海外基盤モデルを基に開発 |
| CC Gov-LLM | カスタマークラウド株式会社 | 行政分野に特化 |
この一覧で注目したいのは、規模の大きいモデルばかりが並んでいるわけではない点です。小規模なモデルや、特定の分野に特化したモデルも選定対象に含まれています。大きいモデルほど計算資源と応答時間を要する場合が多く、大きいほど良いという前提で選ぶと、運用コストに見合わない結果になりかねません。
選定の条件から分かる、企業が確認すべき観点
より参考になるのは、選ばれたモデル名よりも、選定にあたって課された条件です。公募では、機密性2情報(=漏えいすると業務や権利に支障が出る行政情報の区分)を扱えるだけのセキュリティを確保し、ガバメントクラウド上の推論環境で動作することが求められました。
また、海外の主要LLMと比較したベンチマーク結果を提供できること、とくにハルシネーション、バイアス・差別的表現、有害コンテンツ生成に関する安全性の取り組みを複数の評価指標で説明できることが条件とされています。自社の試験だけでは、試した範囲の安全性しか確かめられないためです。
さらに、学習用データについては、法令遵守の状況を具体的に説明できることが条件とされました。加えて、独自開発モデルか派生モデルかの区別を含め、開発経緯・開発方法・開発体制を具体的に説明できることも求められています。提供元が答えられない項目は、導入後に自社が説明を迫られる項目です。
これらはそのまま、企業がLLMを選ぶ際の確認項目として使えます。自社が導入を検討しているモデルについて、学習データの適法性を説明できるか、自社の管理下にある環境で動かせるか、安全性の評価が第三者の指標で示されているかを確認してください。
オープンソースのLLMという選択肢
商用サービスとして提供されるモデルのほかに、重み(=学習済みモデルの本体となるデータ)が公開されているオープンソース系のモデルという選択肢もあります。
東京科学大学と産業技術総合研究所が進めるSwallowプロジェクトや、国立情報学研究所を中心とするLLM-jpなど、研究機関が主導する取り組みからも日本語に対応したモデルが継続的に公開されています。
自社サーバーに構築すれば、入力データを社外に出さずに運用でき、モデルの中身も検証できます。
ただし、公開されていることと自由に商用利用できることは別です。ライセンスの条件はモデルごとに異なり、利用目的や再配布の可否に制限が設けられている場合があるため、検証を始める前に配布元の条項を必ず確認してください。
自社環境での構築については「情報漏洩を防ぐ「ローカルLLM」開発の全貌|要件・RAG構築・導入ステップまで徹底解説」で詳しく解説しています。
参照元:デジタル庁「ガバメントAIで試用する国内大規模言語モデル(LLM)の公募結果」(2026年3月6日公表)
国産LLM導入のメリットと、導入前に知っておくべき限界
国産LLMの利点は、これまで述べたとおりデータの管理と日本語適合、供給の安定性にあります。
一方で、導入を検討する段階で理解しておくべき限界も存在します。第一に、汎用モデルである以上、自社固有の知識は持っていません。社内規程や製品仕様、過去の対応履歴といった情報は学習に含まれていないため、そのまま質問しても正しく答えられません。
この解決には、社内文書を検索して回答に反映させる仕組みを組み合わせる必要があります。質問のたびに関連文書を探して本文を添えるため、学習し直さなくても最新の規程を根拠に答えられます。
第二に、専門分野の正確さです。医薬品の品質保証や法務のように、記載の誤りが重大な影響を及ぼす業務では、汎用モデルの出力をそのまま使うことはできません。学習データに少ない領域ほど、もっともらしい表現で穴を埋めやすく、誤りが文面から見分けにくいためです。
第三に、運用の負担です。自社環境で動かす場合、モデルの規模に応じたGPUなどの計算資源が必要になり、その調達と維持が継続的なコストになります。規模の小さいモデルであれば要件は下がりますが、期待する精度との兼ね合いで決める必要があります。
国産LLM選びで失敗しないためのチェックポイント
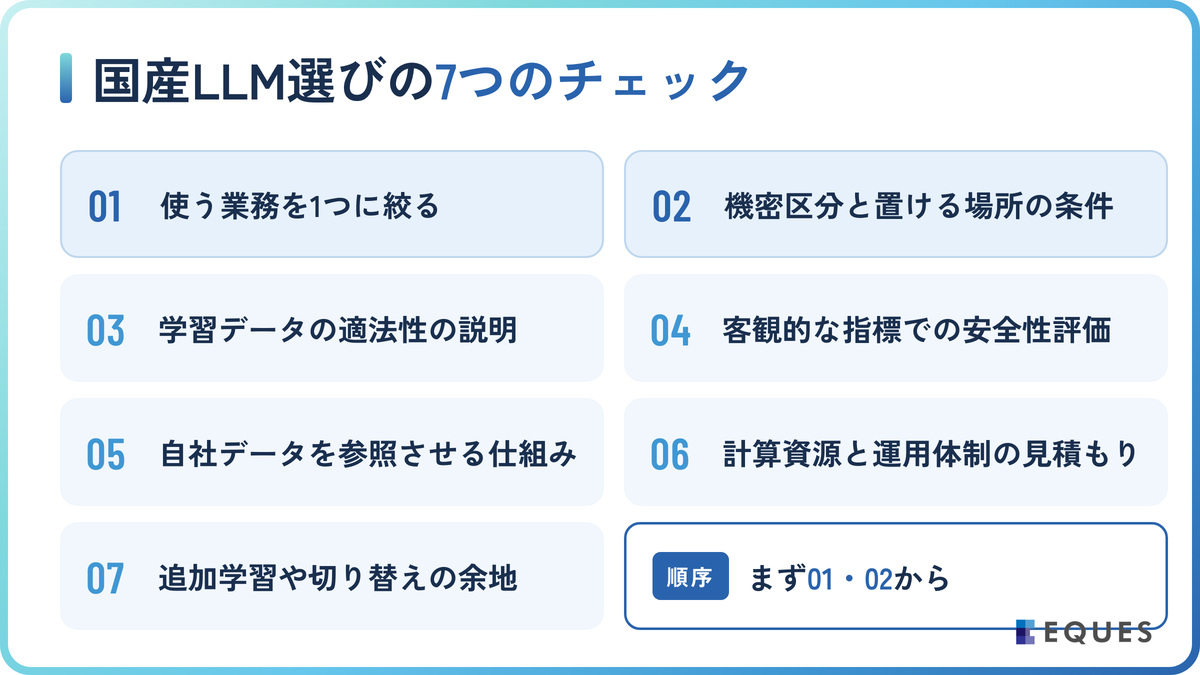
ここまでの内容を踏まえ、検討の際に確認すべき項目をまとめます。導入目的が決まっていない段階でモデルを比較しても結論は出ないため、最初の2項目から順に進めてください。
- □ 何の業務に使うかを1つに絞れているか
- □ 扱う情報の機密区分と、置ける場所の条件が定まっているか
- □ 学習データの適法性を提供元が説明できるか
- □ 安全性の評価が客観的な指標で示されているか
- □ 自社データを参照させる仕組みを併せて設計しているか
- □ 必要な計算資源と、その運用体制を見積もっているか
- □ 精度が不足した場合の追加学習や切り替えの余地があるか
最初の2項目を先にするのは、業務が決まると情報の区分が決まり、区分が決まると置ける場所と候補が絞られるためです。後半を飛ばすと、運用費が見積もりより膨らんだり、精度不足と分かった時点で切り替え先がなく止まったりします。
弊社は東京大学松尾研発のスタートアップとして、企業ごとの要件に合わせたLLMの活用を支援しています。
専門業務における精度の課題に対しては、製薬の品質保証に特化したサービスを提供しており、GMP文書業務を効率化する「QAI Generator」では、簡単な質問に答えるだけで必要書類をAIが自動作成します。
導入企業の万協製薬株式会社では変更申請書を含むGMP文書で70%の業務効率化を実現したと公表しています。弊社の製薬特化型LLMの開発は、経済産業省・NEDOのGENIACにも採択されています。
複数のQA文書間の齟齬を段落ごとに解析して検出する「QAI Checker」もあわせてご利用いただけます。
自社専用の仕組みを検証したい場合は、AI PoCサービス「ココロミ」でスモールスタートから進められます。
モデルの比較検討については「ローカルLLM比較|主要モデル5選と実行ツール3選【2026年最新】」、セキュリティ全般は「2026年版AIセキュリティ完全ガイド|経営者が知るべき対策法」もご覧ください。
国産LLMに関するよくある質問
Q. 日本語に対応したLLMの導入事例にはどのようなものがありますか?
社内文書の検索や部門固有の資料作成といった用途での活用が広がっています。
Q. 導入にはどのくらいの期間がかかりますか?
既存のサービスを利用する形であれば短期間で始められます。自社環境に構築し、社内データを参照させる仕組みまで作る場合は、データの整備状況によって数か月単位の期間を見込む必要があります。
Q. 自社専用にカスタマイズ(ファインチューニング)は可能ですか?
モデルのライセンスと提供形態によります。重みが公開されているモデルであれば追加学習は可能ですが、まずは社内文書を参照させる方式で十分か検討することをおすすめします。そのほうが更新が容易です。
Q. オープンソースの日本語LLMはどこで入手できますか?
研究機関や企業がモデル配布プラットフォーム上で公開しています。
Q. LLMの導入にはどの程度のGPUが必要ですか?
モデルの規模と、同時に何人が使うかによって変わります。まず小さい構成で試し、不足が確認できてから増強する順序が無駄になりません。
まとめ
国産LLMの選定は、性能の順位表を眺めることではなく、自社が扱う情報と業務の要件に照らして条件を満たすかを確認する作業です。本記事の要点は次のとおりです。
- 国産LLMにはフルスクラッチ開発と海外基盤モデルを基にした開発の2方式があり、重視する点で選び方が変わる
- デジタル庁は2026年3月、15件の応募から7つの国内開発LLMを選定した。その選定条件が実務的な判断基準になる
- 汎用モデルは自社固有の知識を持たないため、社内データを参照させる仕組みや業務特化の設計と組み合わせる
導入目的と扱う情報の条件が定まれば、候補は自然に絞り込まれます。自社の要件整理からご一緒することもできますので、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
国産LLMの導入をご検討の方へ
扱う情報の条件と業務の要件整理から、自社専用の仕組みの検証までご一緒します。