記事の要約
- ローカルLLMの評価方法とは、公開ベンチマークの順位ではなく、自社の業務データで作った評価セットに対する精度を測る手順を指します。
- 評価セットは入力・期待出力・採点基準を軸に作り、正答率80%を100件で測ると誤差はおよそ±8ポイントになるため、件数は見たい差の幅で決めます。
- 採点はLLM-as-a-judgeに任せきりにせず、提示順や回答の長さへの偏りを踏まえて人手評価を一部に組み合わせ、モデル更新時・データの変化時・定期に再評価します。
「公開ベンチマークで上位のモデルを選んだのに、自社の問い合わせ対応では誤答が目立つ」。ローカルLLMの導入を進める開発者や推進担当の方から、よく伺う悩みです。
本記事では、公開ベンチマークだけでは足りない理由から、評価セットの作り方、タスク別の指標、LLM-as-a-judge(=別のLLMに採点させる方法)の限界、再評価の頻度まで順に解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社の経験も踏まえています。
目次
ローカルLLMの評価方法とは?公開ベンチマークだけでは足りない理由
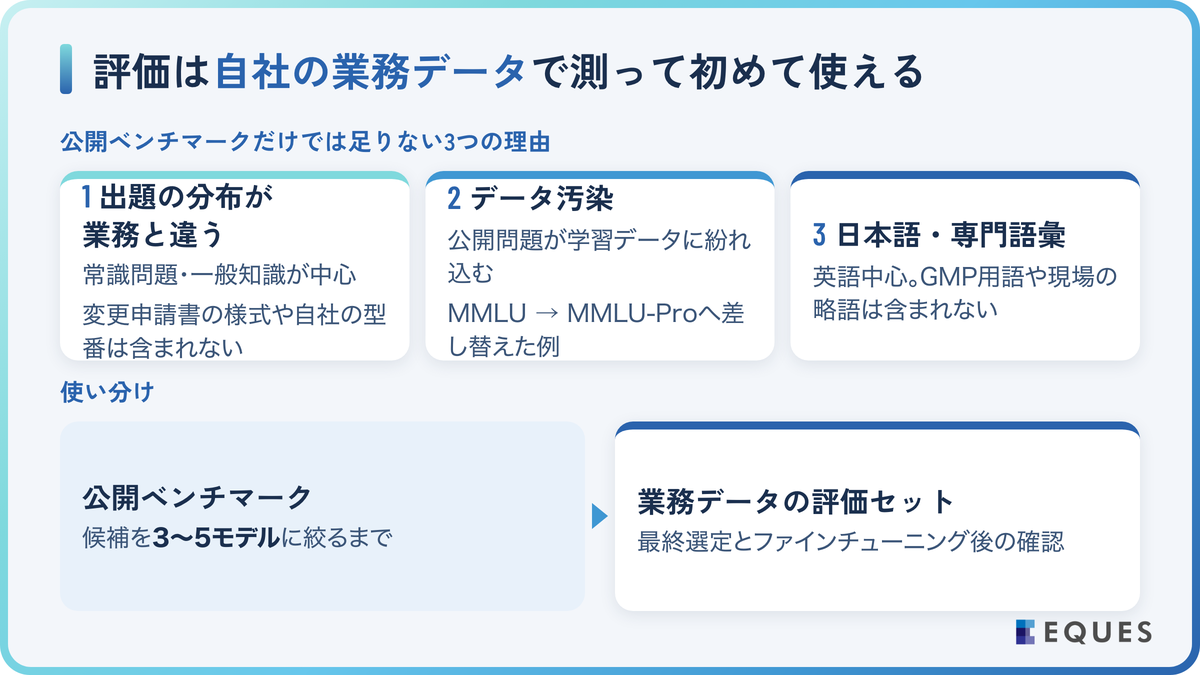
ローカルLLMの評価方法とは、自社の業務データで作った評価セットに対する精度を測る手順を指します。
公開ベンチマークだけでは足りない理由は3つあります。第1に、出題の分布が業務と違うことです。ベンチマークは常識問題や一般知識が中心で、変更申請書の様式や自社製品の型番、社内規程の言い回しは含まれません。
第2に、データ汚染(コンタミネーション)です。公開問題は学習データに紛れ込みやすく、Hugging FaceのOpen LLMリーダーボードも、MMLUで汚染が進んだことを理由の1つに、より難しいMMLU-Proへ差し替えました。覚えていた得点は、初見の業務データでは再現されません。
第3に、日本語と専門語彙への対応です。海外発のベンチマークは英語中心で、日本語ベンチマークでも製薬のGMP用語や製造現場の略語までは一般に含まれないため、自社での確認が欠かせません。
判断としては、公開ベンチマークは候補を3〜5モデルに絞る段階までに使い、最終選定とファインチューニング(=自社データでの追加学習)後の確認は業務データで行います。
候補の絞り方は「ローカルLLMの日本語モデル比較|業務向け7選と選び方2026」で整理しています。
参照元:Hugging Face「Open LLM Leaderboard About」
業務データで評価セットを作る5ステップ(件数と形式)
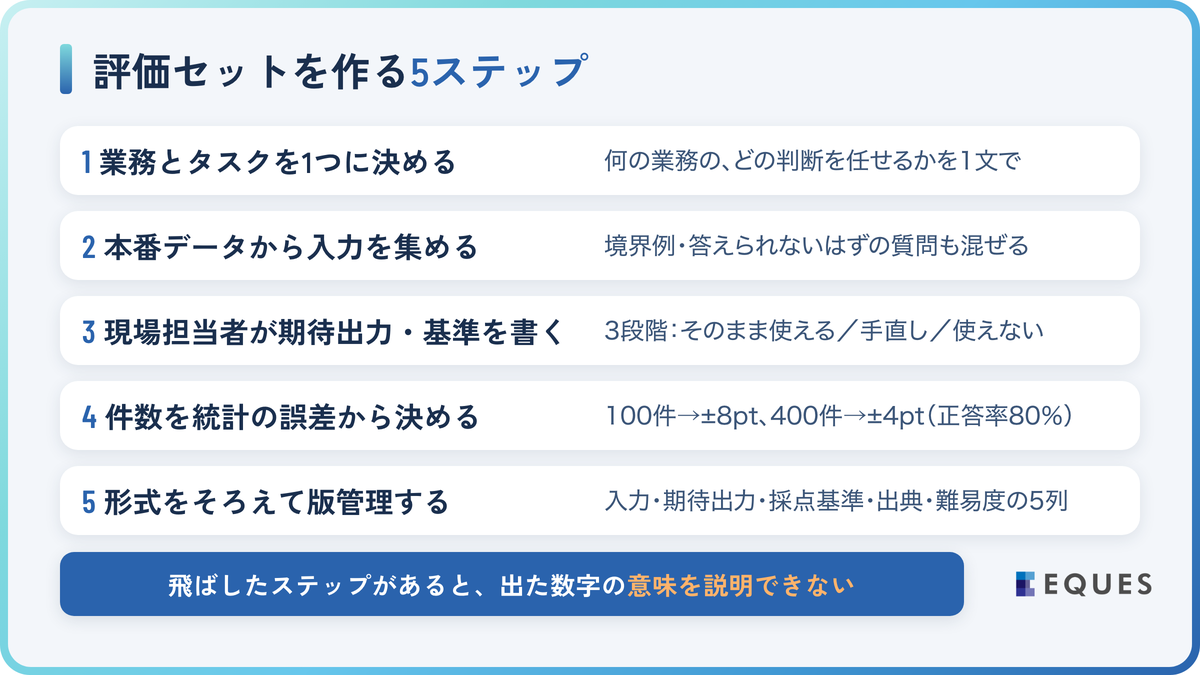
評価セットとは、業務の入力と期待する出力、採点基準を1組にしたデータの集まりです。学習に使った問題で測ると暗記の成果を測ることになるため、学習データとは別に作ります。
弊社がPoC(=本番開発の前に小さく行う技術検証)で評価セットを作る手順は、次の5ステップです。飛ばしたステップがあると、後で出た数字の意味を説明できなくなります。
1. 評価する業務とタスクの種類を1つに決める
最初に、「何の業務の、どの判断を任せるか」を1文で書きます。問い合わせの分類、帳票からの項目抽出、規程に基づく回答生成では、使う指標が変わるためです。ここが曖昧だと採点基準も書けません。
複数の業務を1つの評価セットに混ぜると、どの業務で精度が落ちたのか分からなくなるため、業務ごとに別に作ります。
2. 実際の業務データから入力を集める
入力は、過去の問い合わせログや実際の帳票など、本番で流れるデータからそのまま抜き出します。作文した例題では、現場特有の省略や誤字、長文が再現されません。
個人情報や取引先名は匿名化します。典型例だけでなく、形式を指定する問題・長い入力・自社でしか使わない用語・判断が割れる境界例の4種と、答えられないはずの質問を意図的に混ぜます。本番で先につまずくのはこの種の入力で、典型例だけでは精度が高く出ます。
3. 期待出力と採点基準を現場担当者が書く
期待出力(=正解とみなす答え)は、その業務を日常的に担当している人が書きます。開発者が書いた正解は、現場の判断基準とずれやすいためです。
正解が1つに定まらない生成タスクでは、含むべき要素と含んではいけない要素を採点基準として文章にします。採点基準が書けない問題は、採点者ごとに結果がぶれるため評価セットから外します。
生成タスクの尺度は「そのまま使える/手直しすれば使える/使えない」の3段階にし、導入判断は「そのまま使える」の件数で比べます。人が確認してから使うか顧客にそのまま出すかを先に決めると、許容できる誤りの線が定まり、基準が書けます。
4. 件数を統計の誤差から決める
件数の目安は、見たい精度の差が誤差に埋もれない数です。正答率80%を100件で測ると、二項分布の標準誤差から計算した95%信頼区間はおよそ±8ポイントになります。
つまり100件では78%と84%の差は偶然の範囲で、モデルの優劣は判断できません。400件に増やすと信頼区間はおよそ±4ポイントに縮みます。
5. 形式をそろえて版管理する
形式は、入力・期待出力・採点基準・出典・難易度の5列にそろえ、CSVやJSON Linesで保存します。
版番号を付け、問題を追加したら版を上げます。版が違う評価セットで得点を比べると、モデルの改善と問題の変化が区別できないためです。
ファインチューニングの手順は、親記事「ローカルLLMでファインチューニングを行う方法とは?手順や必要な環境を解説」で解説しています。
タスク別のLLM評価指標|正答率・F1・根拠一致・有害出力率
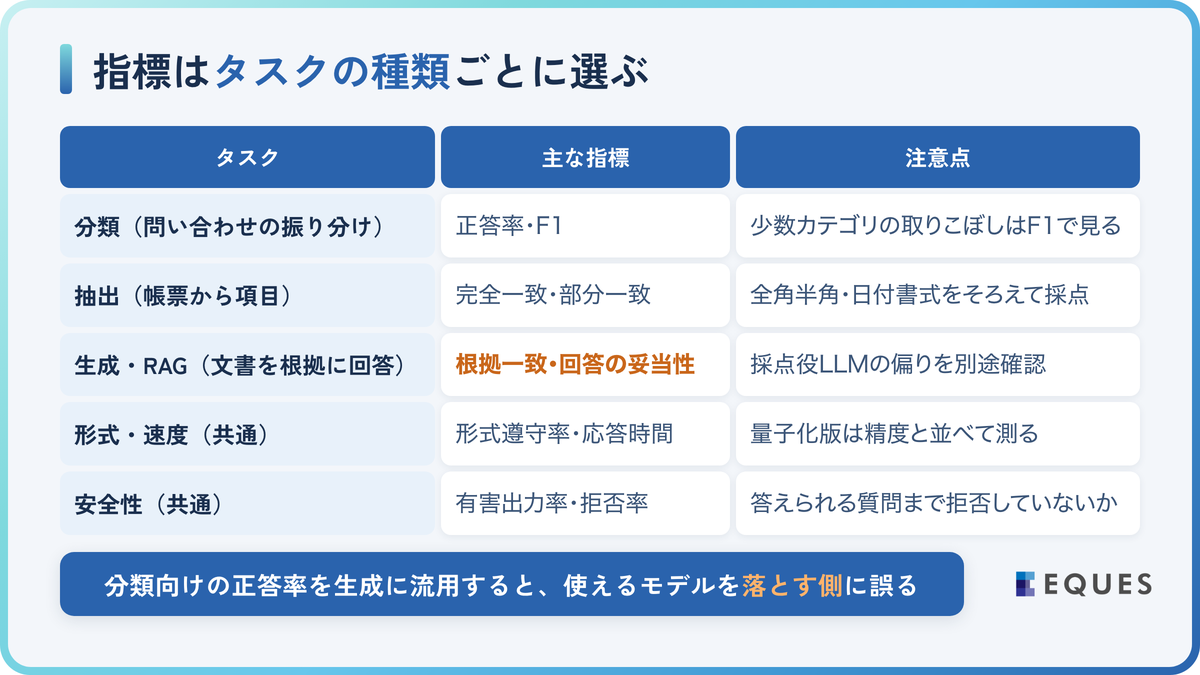
LLMの評価指標は、タスクの種類ごとに選ぶ必要があります。分類向けの正答率を生成タスクに流用すると、言い回しが違うだけの正解を誤答と数えてしまうためです。精度が実際より低く出て、使えるモデルを落とす側の誤りになります。
| タスク | 主な指標 | 指標の意味 | 注意点 |
|---|---|---|---|
| 分類(問い合わせの振り分け) | 正答率・F1 | 正解した割合/適合率と再現率をまとめた値 | 少数カテゴリの取りこぼしはF1で見る |
| 抽出(帳票から項目を取り出す) | 完全一致・部分一致 | 正解と一字違わず一致した割合/一部一致した割合 | 全角半角や日付書式をそろえてから採点する |
| 生成・RAG(文書を根拠に回答) | 根拠一致・回答の妥当性 | 主張のうち根拠文書で裏付けられる割合/質問に正面から答えた度合い | 採点役のLLMの偏りを別途確認する |
| 形式・速度(全タスク共通) | 形式遵守率・応答時間 | 指定した形式どおりに返った割合/回答1つあたりの処理時間 | 量子化版を比べるときは精度と並べて測る |
| 安全性(全タスク共通) | 有害出力率・拒否率 | 不適切な出力の割合/回答を拒否した割合 | 答えられる質問まで拒否していないかも測る |
正答率が少数カテゴリの不調を隠すのは、多数カテゴリの正解だけで率が押し上がるためです。件数の少ない緊急の問い合わせを全件落としても正答率は高いままで、カテゴリごとのF1で初めて表れます。
生成タスクとRAG(=文書を検索し、その内容を根拠に答えさせる検索拡張生成の仕組み)では、根拠一致(faithfulness)が中心です。RAGASの定義では、回答に含まれる主張のうち検索した文脈で裏付けられる割合を0〜1で表し、低い回答は文脈にない内容を補っています。
この補いがハルシネーション(=もっともらしい誤り)で、対策は「ハルシネーション対策とは?原因と安全なAI活用法を徹底解説」で解説しています。
有害出力率は安全性の指標で、日本語では国立情報学研究所のAnswerCarefullyが使えます。1,800件の要注意質問(2024年9月公開の第2版)から成り、商用利用も認められています(再配布は禁止)。
答えられる質問まで拒否していないかも測ります。安全側に寄せすぎたモデルは現場で使われなくなるためです。
参照元:RAGAS「Faithfulness」/国立情報学研究所 大規模言語モデル研究開発センター「AnswerCarefully Dataset」(2024年9月)
LLM-as-a-judgeの使い方と限界|人手評価・再評価との組み合わせ
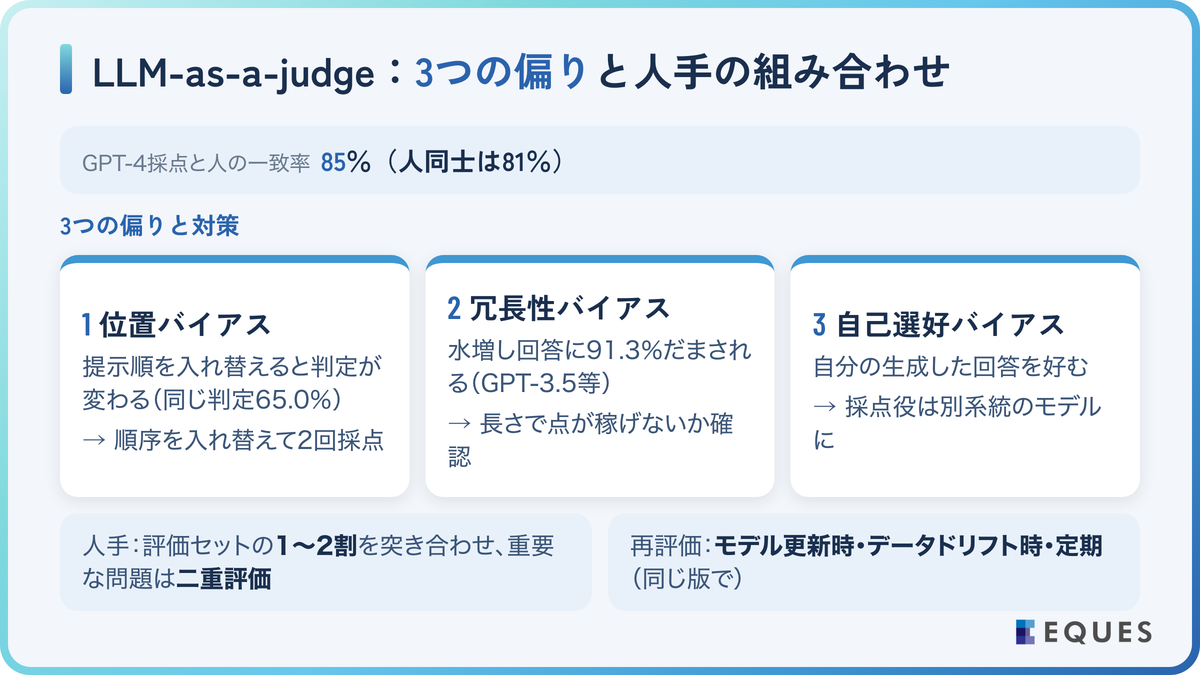
LLM-as-a-judgeとは、採点基準をプロンプトで与え、別のLLMに回答を点数づけさせる方法です。Zhengらの論文(2023年)では、GPT-4を採点役にした場合の人間との一致率は85%(引き分けを除く)で、人間同士の81%と同水準でした。
一方で同論文は3つの偏りを報告しています。第1は位置バイアスで、2つの回答の提示順を入れ替えると判定が変わる現象です。GPT-4でも同じ判定を保てたのは65.0%で、対策は順序を入れ替えて2回採点し、一致した場合だけ採用することです。
採点役も生成モデルなので、先に読んだ回答を基準に後の回答を比べ、順番を手がかりにします。65.0%は、3回に1回は順番だけで判定が入れ替わる水準です。
第2は冗長性バイアスで、長い回答を高く評価する傾向です。繰り返しで水増しした回答に、Claude-v1とGPT-3.5は91.3%の確率でだまされました(GPT-4は8.7%)。
採点役自身が長く丁寧な回答を好む学習を受けているためです。91.3%は、水増し回答の2回に1回以上に点を付ける水準で、長く書くだけで点が稼げます。
第3は自己選好バイアスで、採点役が自分の生成した回答を好む傾向のため、採点役は評価対象と別系統のモデルにします。
偏りがある以上、人手評価をゼロにはしません。第1に、評価セットの1〜2割を抜き取り、人とLLMの採点を突き合わせます(割合は弊社の目安)。一致率が低ければ、採点基準の文章を直してから自動化します。
第2に、重要な問題は2人で独立に採点する二重評価にします。判定が割れた問題は採点基準が曖昧な証拠で、基準の修正対象になります。
再評価が必要なのは、モデル更新時・データドリフト時・定期の3つです。どれも前回と同じ版の評価セットで測り、得点の差を比べます。版が違うと得点の差の原因が分からないためです。
モデル更新時とは、ベースモデルの差し替えや量子化(=モデルを軽くする圧縮処理)の変更で、量子化だけでも精度が変わり得ます。量子化版の比較では形式遵守率と応答時間も測ります。
データドリフトとは、新製品の追加や規程改定で入力の性質が変わることで、本番ログの誤答を評価セットに追加して版を上げます。
定期の再評価は四半期ごとなど業務の変化速度に合わせて決め、怠ると精度低下に気づくきっかけが現場からの苦情になります。
PoCの段階で頻度まで決める進め方は「PoC検証とは?目的と3つの観点・進め方・成功事例を解説」で解説しています。
参照元:Zheng et al.「Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena」(arXiv、2023年6月)
ローカルLLMの評価ツール・ベンチマーク5選の比較
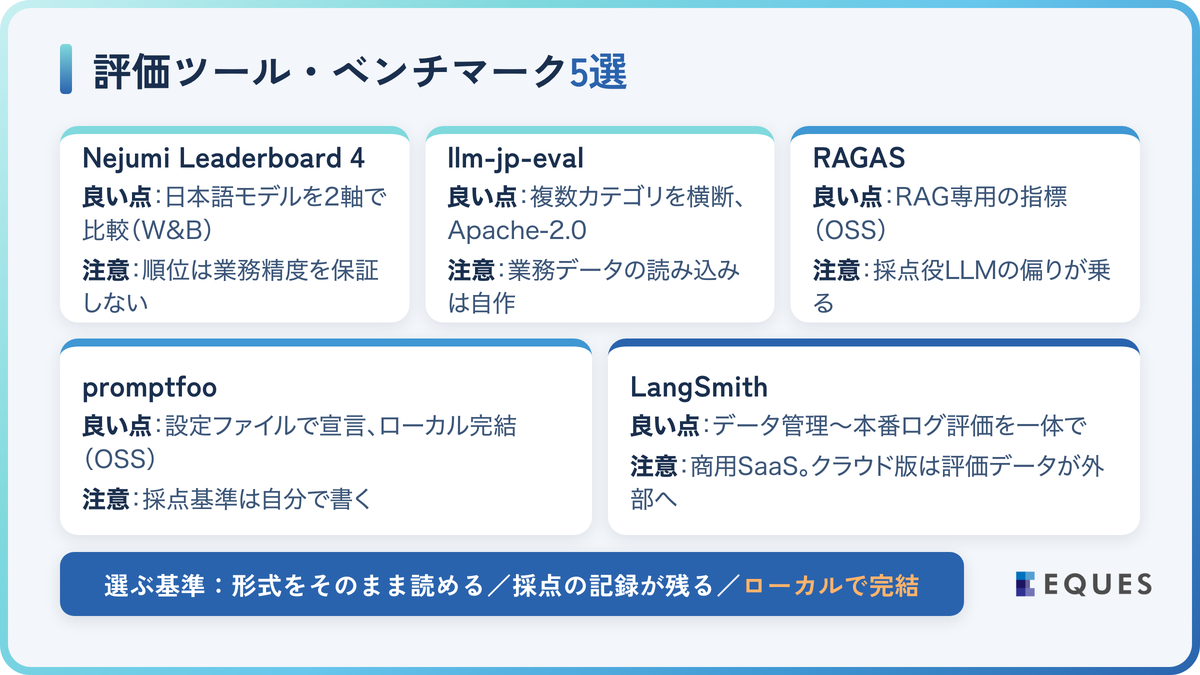
評価セットができたら、採点と記録はツールに任せます。日本語の公開ベンチマーク2つと評価フレームワーク3つを、良い点と注意点で比較します。
| ツール・ベンチマーク | 提供元 | 良い点 | 注意点 |
|---|---|---|---|
| Nejumi Leaderboard 4 | Weights & Biases | 日本語モデルを汎用言語性能とアラインメントの2軸で比較。自社環境でも実行可 | 順位は業務精度を保証しない。一部データは非公開 |
| llm-jp-eval | LLM-jp | 複数カテゴリの日本語データセットを横断して自動評価。Apache-2.0 | データセットごとにライセンスが異なる。業務データの読み込みは自作 |
| RAGAS | オープンソース | 根拠一致・回答の妥当性などRAG専用の指標 | 採点にLLMを使うため採点役の偏りが乗る |
| promptfoo | オープンソース | 設定ファイルで検証項目を宣言し、ローカルだけで実行。レッドチーミング機能も | ドキュメントは英語中心。採点基準は自分で書く |
| LangSmith | LangChain | データセット管理・人手レビュー・LLM採点・本番ログの評価を一体で提供 | 商用SaaS。クラウド版は評価データが外部に出る |
選び方の基準は、評価セットの形式をそのまま読めるか、採点の記録が残るか、ローカルで完結するかの3点です。ローカルLLMを選んだ理由が情報漏洩対策なら、評価データを外部に送るツールは方針と矛盾します。
形式をそのまま読めないと変換を挟み、変換ミスがモデルの精度差に混ざります。記録が残らないと、前回との差が総得点だけになり、どの問題で落ちたか追えません。
このように、ローカルLLMの精度は、自社の評価セットで測って初めて導入判断に使えます。
こうした評価セットの設計とPoCを支援するため、弊社はAI PoCサービス「ココロミ」(スタンダードプラン月々250万円〜)を提供しています。
細胞・遺伝子治療CDMOのCyto-Facto社とのAI-OCR開発では、機器画面の読み取りをサンプル画像で評価し、認識精度100%を達成しています。評価の数字を先に出してから設計を進める考え方は、ローカルLLMでも同じです。
参照元:株式会社EQUES「Cyto-Facto 導入事例」(2025年10月)
ローカルLLMの評価方法に関するよくある質問
Q. 評価セットは何件あれば足りますか?
見たい精度の差で決まります。100件では正答率80%の信頼区間がおよそ±8ポイントになり、数ポイントの差は判断できません。
Q. LLM-as-a-judgeの採点はどこまで信用できますか?
一致率85%の報告がある一方、提示順や長さへの偏りもあります。1〜2割を人手でも採点し、採点役は評価対象と別のモデルにしてください。
Q. ファインチューニング後に精度が下がることはありますか?
あります。学習データに特化しすぎて指示に従えなくなる過学習や、安全性の低下が起こり得るため、前後で同じ版の評価セットを使い、業務指標と有害出力率の両方を比べてください。
まとめ
ローカルLLMの評価方法の核心は、公開ベンチマークの順位ではなく、自社の業務データで作った評価セットで精度を測ることにあります。要点は次のとおりです。
- 公開ベンチマークは候補の絞り込みまでに使い、最終判断は業務データで行う
- 評価セットは本番データから入力を集め、現場担当者が期待出力と採点基準を書き、見たい差の幅から件数を決めて版管理する
- LLM-as-a-judgeは位置・冗長性・自己選好の偏りを踏まえて人手評価と組み合わせ、モデル更新時・データドリフト時・定期に再評価する
評価セットの設計でお困りの際は、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
業務データでの評価セットづくりから、伴走しませんか
評価セットの設計と精度の実測を、AI PoCサービス「ココロミ」で支援します。まずは無料相談からどうぞ。