記事の要約
- ローカルLLMの高速化とは、遅さの原因を切り分けて速くする手順で、主因は計算力ではなく、トークンごとに重み全体を読み出す「メモリ帯域の壁」にあります。
- 量子化は重みのデータ量を減らして帯域の壁を下げる手法で、公式資料ではLlama-3.1-8Bが16bitの約15GiBから4bit級の約4.6GiBに縮みます。
- 症状を「最初の1トークンまでの時間」と「1トークンあたりの時間」に分けて計測し、量子化・推論エンジン・バッチ処理・KVキャッシュのどれを使うか決めます。
「ローカルLLMの回答が1文字ずつしか出てこない」「同時に数人が使うと止まる」。開発者や情報システム部門からよく受ける相談です。
遅さの原因を切り分けて精度を落とさずに速くする手順として、量子化・推論エンジン・バッチ処理・KVキャッシュの4手法をどの症状に向くかで解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社の経験も踏まえます。
目次
ローカルLLMが遅い3つの原因|メモリ帯域・モデル規模・実装
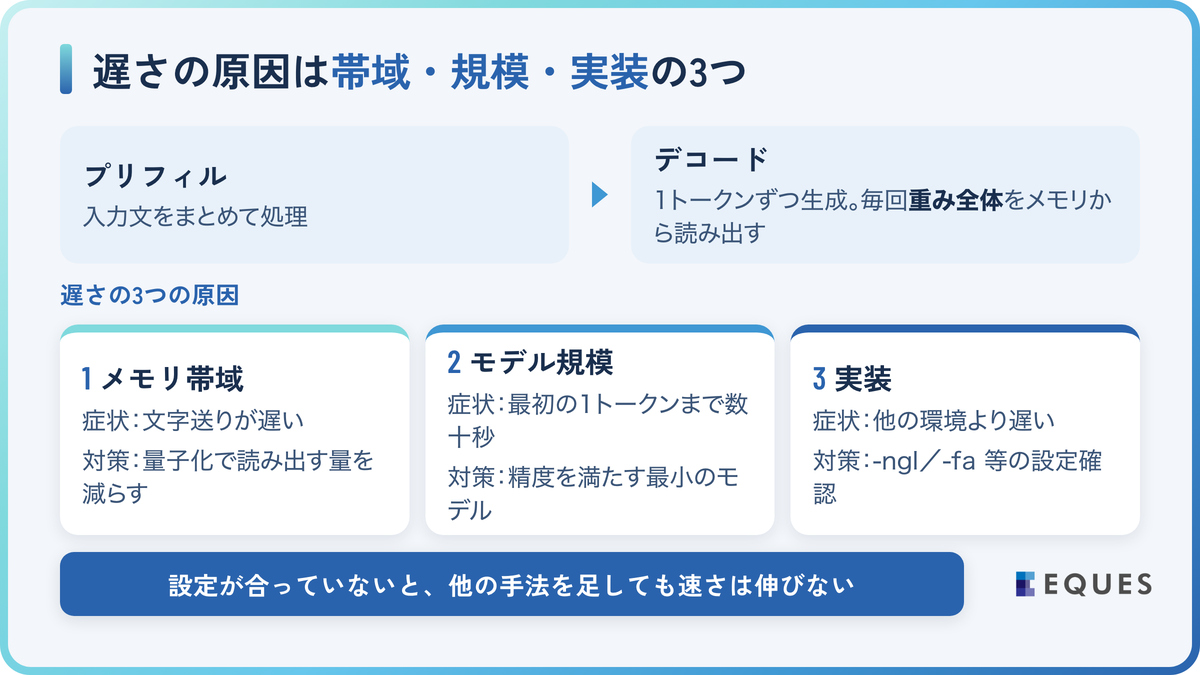
ローカルLLMの推論は、入力文をまとめて処理する「プリフィル」と、回答を1トークンずつ生成する「デコード」の2段階で進みます。トークン(=モデルが文章を扱う最小単位)を1つ生成するたびに、モデルの重み全体をGPUメモリから読み出します。
このためデコードの速度は、計算力ではなく重みを運ぶメモリの速さで決まります。遅さの原因は3つです。
1. メモリ帯域:重みの読み出しが毎トークン発生する
重みが大きいほど毎トークンの読み出し量が増えるため、1トークンあたりの時間が伸びます。VRAMに収まらず一部をCPUメモリに置くと、帯域は大きく落ちます。
症状は、最初の1トークンは待てるのに、その後の文字送りが遅い形で現れます。これには量子化で読み出す量そのものを減らす手が有効です。
2. モデル規模:パラメータ数と文脈長がそのまま時間に乗る
パラメータ数が2倍なら読み出し量も2倍になり、文脈長(=一度に扱える入力と出力の合計トークン数)が長いほどプリフィルの計算が増えます。
KVキャッシュ(=生成済みトークンの計算結果を保存する領域)も文脈が長いほど膨らみ、症状は社内文書を丸ごと貼る使い方で最初の1トークンまでが数十秒に伸びる形で現れます。業務に必要な精度を満たす最小のモデルを選ぶことが最初の判断です。
3. 実装:推論エンジンと設定で数倍の差が出る
同じモデル・同じGPUでも、推論エンジンと設定で速度は数倍変わり得ます。
GPUに載せる層数が足りずCPUで動いている例や、リクエストを1件ずつ処理していて複数人で使うと急に遅くなる例が典型です。後者にはバッチ処理が有効です。
実装が原因かどうかは、まず次の設定を確かめます。llama.cppなら-ngl(GPUに載せる層数)と-fa(Flash Attention)、Ollamaなら環境変数OLLAMA_FLASH_ATTENTION=1です。
vLLMなら–gpu-memory-utilization(GPUメモリのうち使う割合)と–max-num-seqs(同時に処理する系列数)です。ここが合っていないと、他の手法を足しても速さは伸びません。
参照元:NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(2023年11月)/ggml-org「llama-server README」/Ollama「FAQ」/vLLM「Engine Arguments」
ローカルLLMの量子化|種類と精度への影響
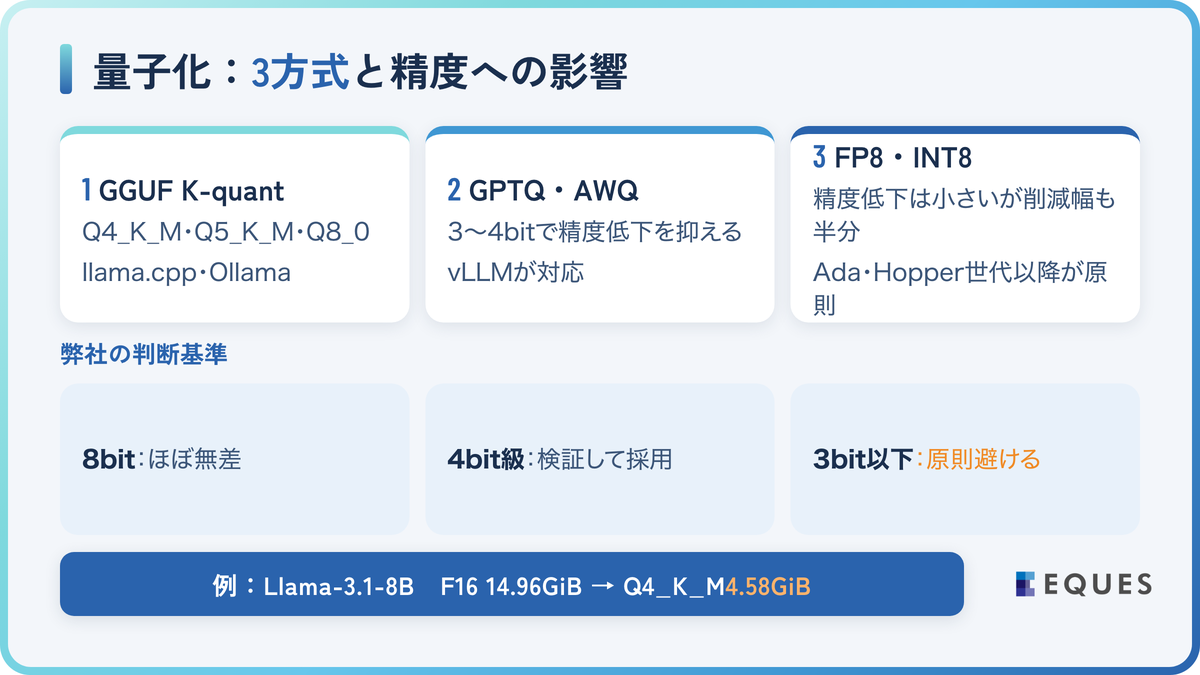
量子化とは、モデルの重みを16bitから8bitや4bitに丸めてデータ量を減らす処理です。読み出すバイト数が減るため、メモリ帯域の壁を直接下げられます。一方、丸めると小さな重みどうしの差が区別できなくなるため、bit数を下げるほど精度は落ちます。
Llama-3.1-8Bを16bit(F16)から4bit級(Q4_K_M)にすると14.96GiBのファイルが4.58GiBに縮み、VRAM 8GBのGPUにも載る計算です。
量子化の3方式|GGUF・GPTQ/AWQ・FP8
第1はGGUF形式のK-quant(Q4_K_M・Q5_K_M・Q8_0など)で、llama.cppとOllamaで使われます。
第2はGPTQとAWQで、vLLMが対応します。GPTQは3〜4bitで精度低下をほぼ抑えたとし(Frantarら、2022年)、AWQは重要度の高い1%の重みを保護します(Linら、2023年)。
第3はFP8やINT8で、精度低下が小さい代わりに削減幅も半分です。FP8のネイティブ演算は原則としてAda・Hopper世代以降のGPUに限られるため、先にGPU世代で絞ります。
精度への影響と選び方
精度低下はパープレキシティ(=モデルが次の語をどれだけ迷うかの指標)で測るのが標準です。指標が小さくても業務の回答品質が保たれる保証はありません。4bit級で精度が落ちると、数値や固有名詞、表の中の値を取り違える形で業務回答に出ます。
弊社の判断基準は8bitはほぼ無差、4bit級は検証して採用、3bit以下は原則避けるです。3bit以下では容量の減り方に対して精度の落ち方が大きく、業務で許される範囲に収まりにくいためです。
再量子化は品質が落ちるため、16bit以上の元モデルから作られた版を選びます。候補の絞り込みは「ローカルLLM比較|主要モデル5選」が参考になります。
参照元:ggml-org「llama.cpp quantize README」「GGUF」/Frantarら「GPTQ」(2022年10月)/Linら「AWQ」(2023年6月)/vLLM「Quantization」
推論エンジンの使い分け|vLLM・llama.cpp・Ollama・TensorRT-LLM・SGLang
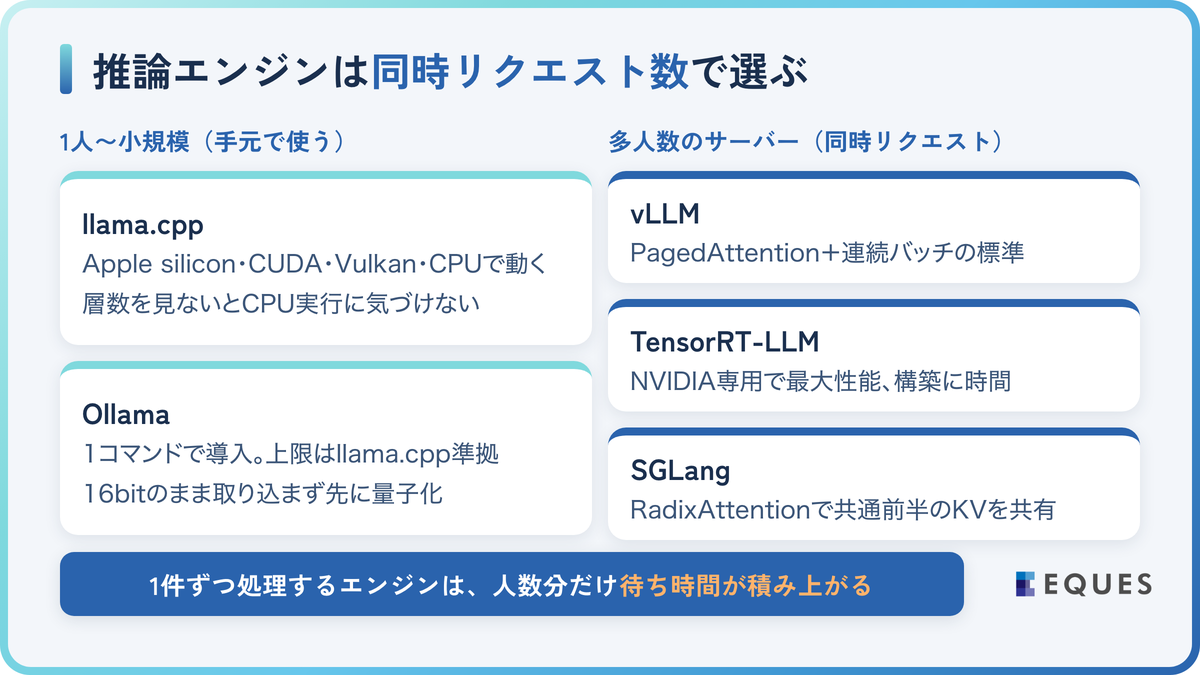
推論エンジンは、「1人が手元で使う」か「数十人が同時に使う」かで選び方が変わります。1件ずつ処理するエンジンでは、利用者が増えた分だけ重みの読み出しが繰り返されるからです。
連続バッチ処理(後述)に対応したエンジンなら処理量が伸びますが、手元用のエンジンを多人数のサーバーに使うと待ち時間が人数分だけ積み上がります。
| ツール | 向く規模 | 機材 |
|---|---|---|
| vLLM | 多人数のサーバー | NVIDIA・AMD GPUなど |
| llama.cpp | 個人〜小規模 | Apple silicon・CUDA・Vulkanなど |
| Ollama | 個人・検証 | macOS・Windows・Linux |
| TensorRT-LLM | 多人数のサーバー | NVIDIA GPUのみ |
| SGLang | 多人数のサーバー | NVIDIA・AMD・TPUなど |
vLLM:同時リクエストの多いサーバー用途の標準
PagedAttention(=KVキャッシュをページ単位で管理する手法)と連続バッチ処理で多数の同時リクエストをさばけます。公開時のベンチマークではHugging Face Transformers比で最大24倍のスループットを示しました(2023年6月、条件は参照元)。
一方、LinuxとGPUが前提で、GPUメモリの割り当てが小さいとKVキャッシュに回る分が減り、同時数が頭打ちになります。
llama.cpp:Apple siliconやCPUを含む幅広い機材で動く
Apple siliconからCUDA・AMD・Vulkanまで幅広く対応し、1.5〜8bitの量子化を自前で持ちます。
一方、多数の同時リクエストではvLLMほど伸びず、GPUバックエンドを有効にしてビルドしないとCPU実行になります。エラーは出ず遅くなるだけなので、起動ログの層数表示を見ないと気づけません。
Ollama:llama.cppをバックエンドに1コマンドで導入
「ollama run モデル名」だけで取得から実行まで完了するのが利点です。
一方、速度の上限はllama.cppに準じ、GGUF取り込み時に量子化しません。16bitのまま取り込むと帯域の壁が残るため、公式はllama-quantizeで先に量子化するよう案内しています。
TensorRT-LLM・SGLang:特定の条件で最大性能を狙う
NVIDIA GPU専用に最適化した実装で、環境構築に時間がかかるため、専任のエンジニアを置ける組織に向きます。
RadixAttention(=共通する前半のKVキャッシュを共有する手法)で同じシステムプロンプトを繰り返し使う処理に向きますが、国内の導入情報は少なめです。選定後の構築手順は「ローカルLLM構築の進め方」で整理しています。
参照元:vLLM「vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention」(2023年6月)/ggml-org「llama.cpp README」/Ollama「README」「Importing models」/NVIDIA「TensorRT-LLM README」/SGLang「Documentation」
バッチ処理とKVキャッシュ|同時アクセスに強くする仕組み
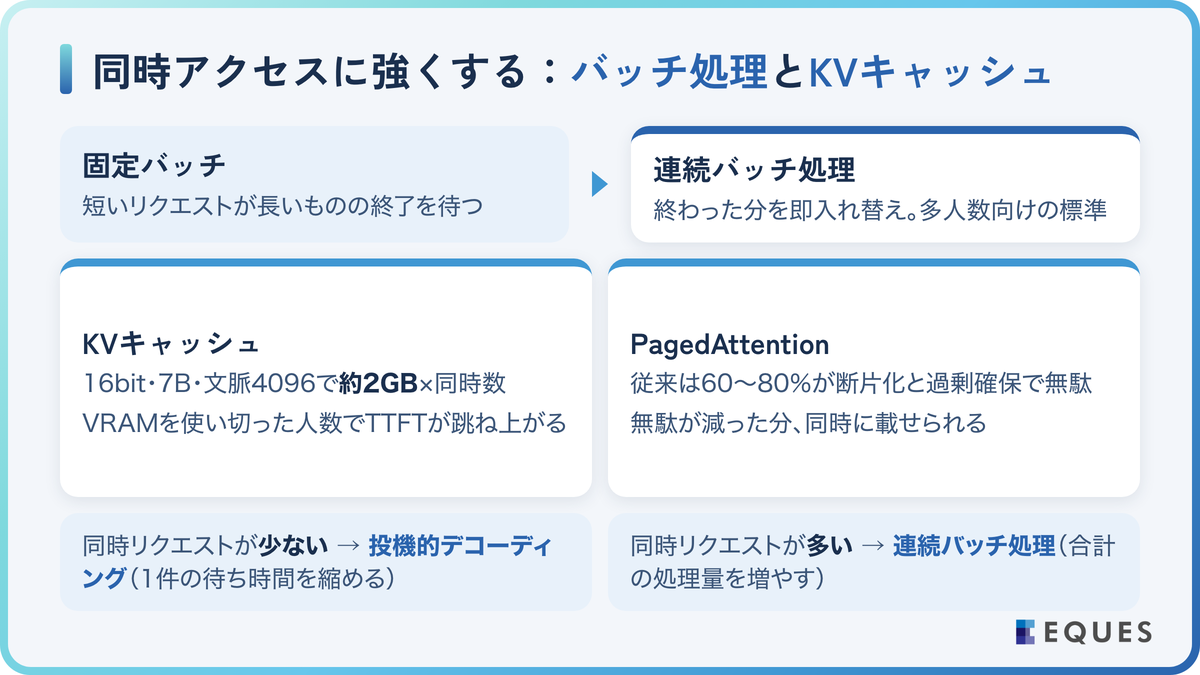
バッチ処理とは、複数リクエストのトークン生成を1回の重み読み出しでまとめて進める方法です。読み出しを共有するため、スループット(=単位時間に生成できるトークン数)は同時数が増えても伸びます。
固定バッチでは短いリクエストが長いものの終了を待たされるため、終わった分を即座に入れ替える連続バッチ処理が多人数向けエンジンの標準です。
KVキャッシュは16bitのLlama 2 7Bで文脈長4096・バッチ1のとき約2GBに達し、同時数に比例して増えます(NVIDIA技術ブログ)。
同時数を増やすと、ある人数でKVキャッシュがVRAMを使い切り、そこを境にTTFTが跳ね上がりtokens/sが急落するか、新しいリクエストが待たされます。
vLLMの開発チームは、従来の実装ではKVキャッシュの60〜80%が断片化と過剰確保で無駄になっていたとし、PagedAttentionで解消しました。無駄が減った分、同時に載せられるリクエストが増えます。
投機的デコーディングは、小さなドラフトモデルが数トークン先の候補を出し、本来のモデルが並列に検証する方法で、出力を変えずにT5-XXLで2〜3倍の高速化が示されています(Leviathanら、ICML 2023)。
判断基準は同時リクエストが少なければ投機的デコーディング、多ければ連続バッチ処理です。前者は1件ごとの待ち時間を縮め、後者は人数が増えたときの合計の処理量を増やす手法だからです。
参照元:vLLM「Speculative Decoding」/Leviathanら「Fast Inference from Transformers via Speculative Decoding」(2022年11月)
ローカルLLM高速化の効果を計測する方法|TTFT・tokens/s・同時数
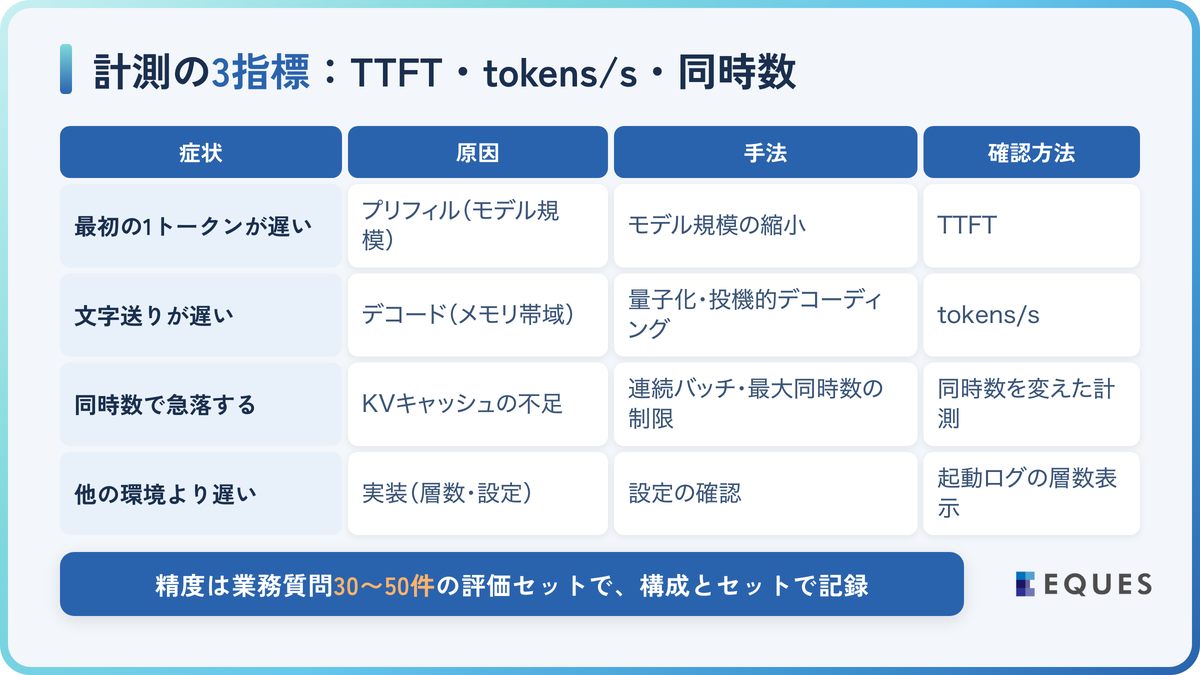
指標はTTFT・1トークンあたりの時間・同時数での劣化の3つです(TTFT=最初のトークンが返るまでの時間)。
| 応答速度の症状 | 原因 | 手法 | 確認方法 |
|---|---|---|---|
| 最初の1トークンが遅い | プリフィル(モデル規模) | モデル規模の縮小 | TTFT |
| 文字送りが遅い | デコード(メモリ帯域) | 量子化・投機的デコーディング | tokens/s |
| 同時数で急落する | KVキャッシュの不足 | 連続バッチ処理・最大同時数の制限 | 同時数を変えた計測 |
| 同じモデルなのに他の環境より遅い | 実装(層数・設定) | 設定の確認 | 起動ログの層数表示 |
llama.cppは「llama-bench」で単体のtokens/sを記録し、同時数はllama-serverに外部から負荷をかけて測ります。
vLLMなら「vllm bench serve」(–max-concurrency)で同時数を変えて測ります。同時数を変えずに測ると、1人では速いのに本番で数人目から急落する問題を見逃します。
精度の確認には、業務で実際に投げる質問をまず30〜50件集め、期待回答とともに評価セットにします。評価セットがないと、精度低下に気づかないまま本番に出し、利用者の指摘で発覚します。
F16か8bitの出力を基準に4bit版を採点し、正答が許容幅を超えて落ちるなら8bitに戻します。
結果は構成(モデル・量子化・エンジン・設定)とセットで記録し、構成を変えるたびに同じ評価セットで再計測します。記録がないと、どの変更で速くなったかを後から再現できません。
ファインチューニング時の評価の考え方は「ローカルLLMでファインチューニングを行う方法」、機材費用は「ローカルLLMの費用相場」をご参照ください。
どの構成なら業務に耐えるかを小さく確かめる支援として、弊社はAI PoCサービス「ココロミ」(スタンダードプラン月々250万円〜)を提供しています。
SOLIZE PARTNERS株式会社とのPoCでも、熟練技術者の知見をシステム化できるかを同じ手順で検証しました。
参照元:vLLM「Benchmark CLI」/ggml-org「llama-bench README」/株式会社EQUES「SOLIZE PARTNERS株式会社 導入事例」
ローカルLLMの高速化に関するよくある質問
Q. 量子化すると精度はどれくらい落ちますか?
8bitではほぼ差が出ず、4bit級は業務質問で作った評価セットで採点して判断してください。
Q. vLLMとOllamaはどちらを選ぶべきですか?
数人までが手元で使うならOllama、数十人が同時に使うサーバーならvLLMが目安です。
Q. GPUがないCPUだけの環境でも高速化できますか?
llama.cppで4bit級に量子化した7〜8Bモデルが現実的な上限で、必要なスペックは「ローカルLLMとは?必要なPCスペック2026」をご参照ください。
まとめ
ローカルLLM高速化の出発点は、遅さの原因がメモリ帯域・モデル規模・実装のどれかを計測で切り分けることです。
- 量子化で読み出す量を減らすことが最も直接的な高速化になる
- 推論エンジンは同時リクエスト数で選ぶ:1人ならllama.cpp・Ollama、多人数ならvLLM・TensorRT-LLM・SGLang
- TTFT・tokens/s・同時数での劣化を計測し、業務質問の評価セットで精度を確かめてから構成を決める
どの構成から試すべきか迷う段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
業務に耐える推論構成を、実測で決めませんか
量子化や推論エンジンの構成比較を、AI PoCサービス「ココロミ」で支援します。まずは無料相談からどうぞ。