記事の要約
- RAGの精度向上は、誤答の原因が「検索で正しい根拠を拾えていない」のか「拾えた根拠から正しく答えられていない」のかを切り分けることから始まります。
- Anthropicの検証では、チャンクへの文脈付与・BM25・再ランクを重ねると、関連情報のうち上位20件に入らない割合(検索失敗率)が5.7%から1.9%へ67%下がりました。
- 改善は評価セット(=質問と正解を組にした検証用データ)で検索と生成を分けて測り、分割、ハイブリッド検索、再ランク、生成側の調整の順に1つずつ変えて効果を確かめます。
「型番を聞くと別製品の手順書を返す」「根拠の文書は合っているのに、回答に文書にない条件が混ざる」。RAGの精度向上で開発者や情報システム部門の方が直面しやすい悩みです。
本記事では、誤答の切り分け方、検索精度を上げる手法、評価指標と改善の順番を解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社が、Anthropic・Microsoft・Cohereなどの公開資料をもとに整理しました。
目次
RAGの精度が出ないときは「検索か生成か」を先に切り分ける
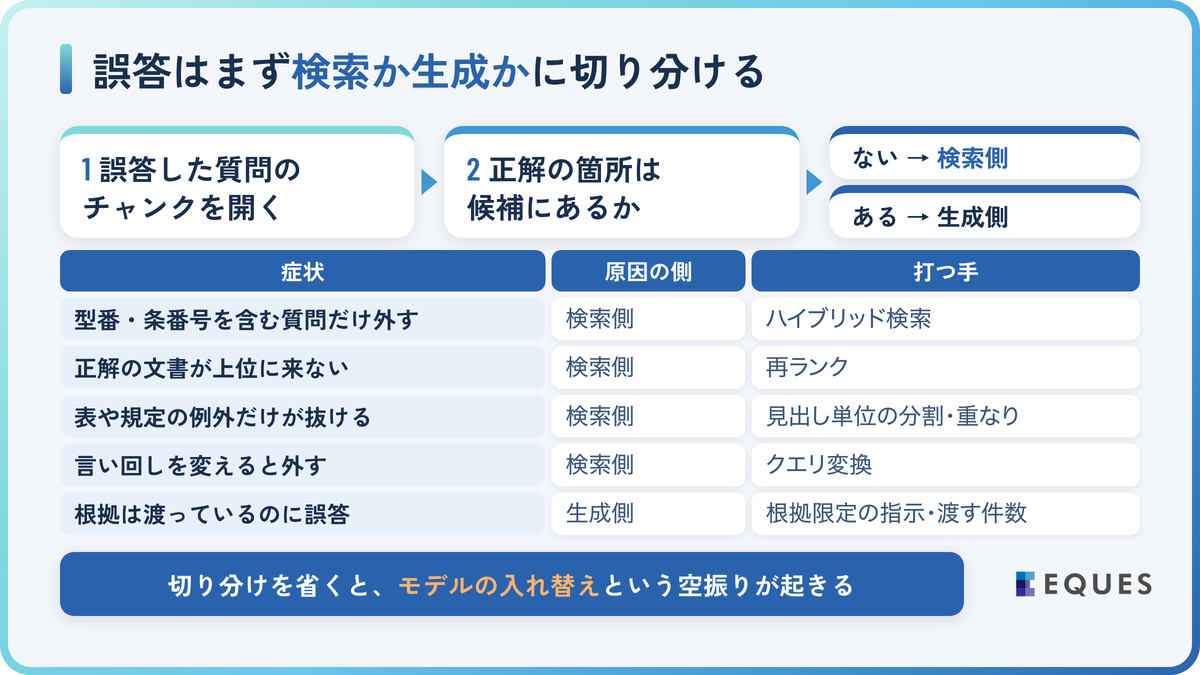
RAG(検索拡張生成)は、文書を検索し、その内容を根拠に生成AIに答えさせる仕組みです。その精度は、検索の精度(必要な文書を拾えるか)と回答の精度(拾った文書から正しく答えるか)に分けて考えます。
そのため最初にすべきことは、手法を足す前に、誤答が検索と生成のどちらで起きているかを特定することです。
切り分けでは、誤答した質問ごとに、取り出したチャンク(=検索の単位として文書を区切った断片)の中身を確認します。正解の箇所が候補に入っていなければ検索側、入っているのに誤答なら生成側です。
正解のチャンクが候補にないと、生成AIは手元の別の断片や自身の知識で答えを埋めます。その結果、文書にない条件が混ざったもっともらしい誤答になり、生成側の誤りに見えます。
この確認を省くと、根拠が渡っていない誤答をモデルの入れ替えで直そうとする無駄な作業が生じます。症状と打つ手の対応は次のとおりです。
| 症状 | 原因の側 | 主な原因 | 打つ手 |
|---|---|---|---|
| 型番・条番号を含む質問だけ外す | 検索側 | ベクトル検索が完全一致に弱い | ハイブリッド検索 |
| 正解の文書は候補に出るが上位に来ない | 検索側 | 順位付けが粗い | 再ランク |
| 表や規定の例外だけが答えから抜ける | 検索側 | 意味の途中でチャンクが切れている | 見出し単位の分割・重なり |
| 「本規定」など指示語の多い文書で外す | 検索側 | チャンク単体で文脈が分からない | チャンクへの文脈付与 |
| 言い回しを変えると外す | 検索側 | 質問と文書の言葉のずれ | クエリ変換 |
| 根拠は渡っているのに誤答する | 生成側 | 指示や渡し方の不備 | 根拠限定の指示・渡す件数の調整 |
原因の全体像やモデル変更の判断は「RAG導入で精度が出ない3つの原因と改善手順【2026年版】」で整理しています。
RAGのチャンク分割と埋め込みで「探せる単位」に整える
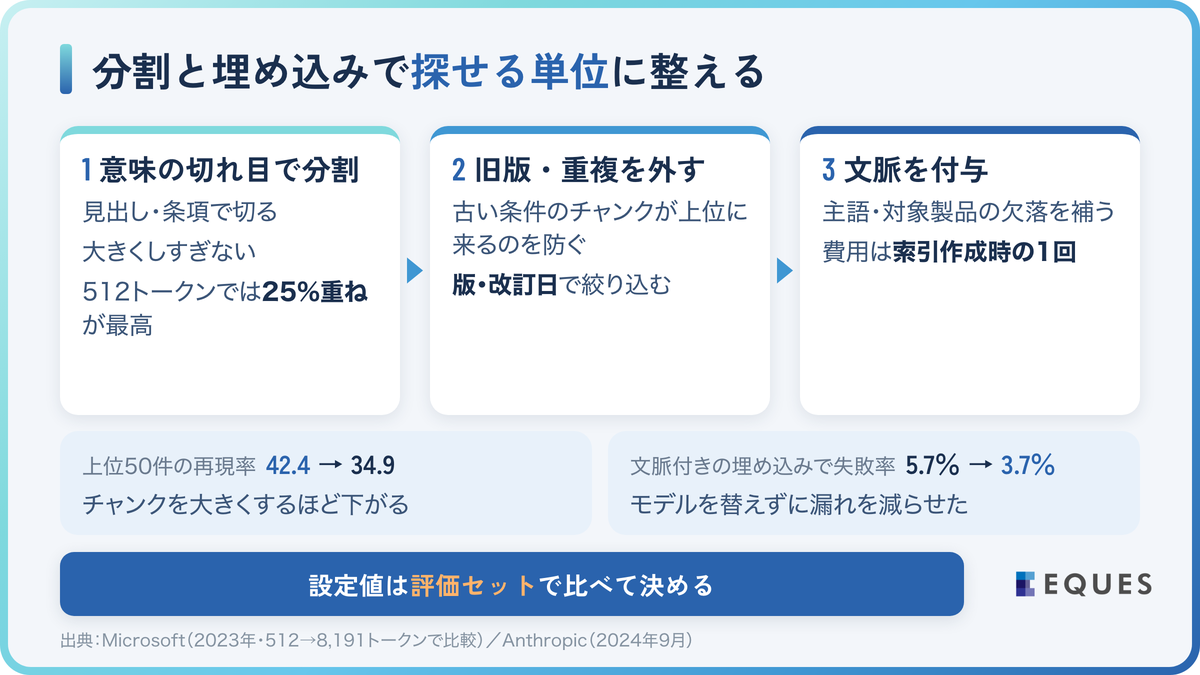
文書をどの単位で切り、どう数値に変えるかで、後段の検索が拾える候補が決まります。
チャンク分割の基本は、見出しや条項など意味の切れ目で切り、1チャンクを大きくしすぎないことです。固定字数で機械的に切ると、規定の本文と例外が別のチャンクに分かれ、片方だけが検索に掛かります。
Microsoftは2023年、同社の顧客データ4種から作ったベンチマークで、チャンクを512トークン(=文章の長さを数える単位)から8,191トークンまで変えて検索の再現率(=拾うべき箇所のうち拾えた割合)を比べました。
上位50件の再現率は、512トークンで42.4、8,191トークンで34.9でした。大きなチャンクは複数の話題を1つの数値にまとめるため、個々の話題との近さが薄まり、検索で埋もれやすくなります。
同じ検証の512トークンのチャンクでは、隣と25%重ねる分割が最も高い値でした。重ねると、境目にまたがる記述がどちらかのチャンクに丸ごと残るためです。設定値は評価セットで比べて決めます。
改訂前の規程や重複ファイルが索引に残ると、古い条件のチャンクが上位に来て、根拠は渡っているのに古い答えが返ります。旧版と重複を検索対象から外し、版や改訂日などのメタデータ(=文書に付ける属性情報)で絞り込むと防げます。
埋め込み(=文章を意味の近さで比べられる数値の列)では、モデル選びより先にチャンク単体で主語や対象製品が分からない状態を補います。この欠落があると、どのモデルでも質問と結び付きにくくなります。
その手法がAnthropicのContextual Retrieval(文脈付与)で、各チャンクの前に文書内での位置づけを示す短い説明をLLM(=生成AIの中核となる言語モデル)で付けてから索引を作ります。
同社は、関連する情報のうち上位20件に入らなかった割合(1−Recall@20)を失敗率とし、コードや論文などのデータで測りました。文脈付きの埋め込みだけで失敗率は5.7%から3.7%に下がり、モデルを替えずに漏れを減らせたことになります。
文脈の生成費用は、プロンプトキャッシュ(=入力の再処理を省く機能)を使う前提の試算では文書100万トークンあたり約1.02ドルで、索引作成時に一度だけ掛かります。
同社は、検索対象の文書全体が20万トークン(約500ページ)未満なら、RAGを使わず全文をプロンプトに入れる方法も挙げています。
日本語の埋め込みモデルの選び方は「ローカルLLMでRAG構築|社内文書検索を安全に作る5ステップ」で解説しています。
参照元:Microsoft「Azure AI Search: Outperforming vector search with hybrid retrieval and reranking」(2023年9月・2024年11月更新)/Anthropic「Introducing Contextual Retrieval」(2024年9月)
ハイブリッド検索・再ランク・クエリ変換で検索精度を上げる
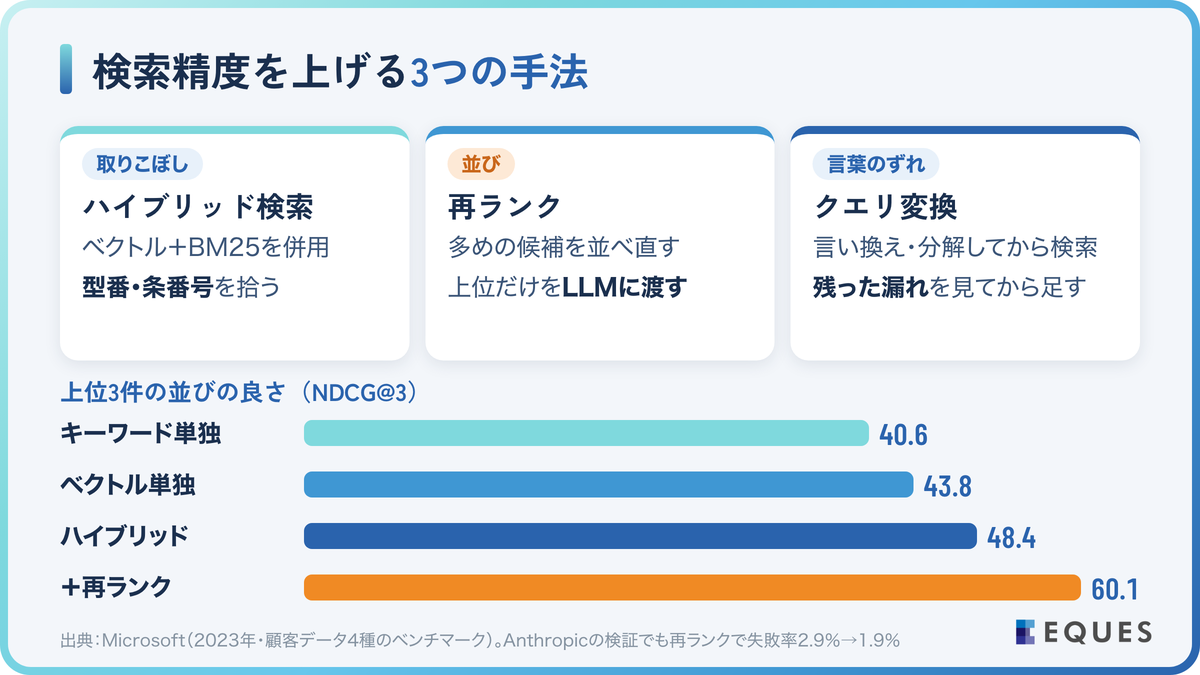
分割と埋め込みを整えても残る検索漏れは、検索の方式と順位付けで補います。再ランクとクエリ変換は索引を作り直さずに足せることが多く、ハイブリッド検索もキーワード用の索引を加えて組むのが一般的です。
以下、取りこぼしを補うハイブリッド検索、並びを整える再ランク、言葉のずれを埋めるクエリ変換の順に仕組みを説明します。
ハイブリッド検索は型番・条番号の取りこぼしを防ぐ
ハイブリッド検索とは、ベクトル検索とキーワード検索を並行して実行し、結果を1つの順位にまとめる方式です。キーワード側にはBM25(=語の出現頻度などで文書に点数を付ける方式)が広く使われます。
ベクトル検索は文の意味の近さで比べるため、言い換えに強い一方、製品コード・専門用語・日付・人名のような完全一致が要る質問に弱い性質があります。
一字違いの型番を同じものとみなし、別製品の手順書を上位に出すのはこのためで、文字の一致で採点するキーワード検索で補います。
Microsoftの同じ検証(2023年・同社の顧客データ4種のベンチマーク)では、上位3件の並びの良さを示すNDCG@3が、ベクトル単独43.8に対してハイブリッドは48.4でした。
キーワード単独は40.6で、どちらか一方より両方を併せたほうが高い結果です。2つの検索は外す質問の種類が異なり、片方が落とした正解をもう片方が拾うためと考えられます。
再ランクは「LLMに何を渡すか」の質を上げる
再ランク(=検索候補を別のモデルで並べ直す処理)は、最初の検索で多めに取った候補を採点し直し、上位だけをLLMに渡す手法です。
最初の検索は質問と文書を別々に数値にして比べるため速い反面、細かな関連を見落とします。再ランクは両者を一緒に読んで採点するので精度は高いが遅く、最初の検索は速さ優先、再ランクは精度優先と役割を分けます。
Microsoftの同じ比較で、上位50件を並べ直すセマンティックランカー(同社の再ランク機能)を加えると、NDCG@3が48.4から60.1に上がりました。渡す上位3件に正解に近い文書が並ぶようになったという意味です。
Anthropicの検証でも、候補150件をCohereの再ランクモデルで上位20件に絞ると、文脈付与とBM25の併用で2.9%だった失敗率が1.9%になり、当初からの削減率は67%に達しました。
Cohere Rerankは関連度を0〜1の点数で返します。点数が2倍でも関連度が2倍とは限らないため、足切りの閾値は自社の代表的な質問30〜50件で決める方法が公式に示されています。各質問と関連性がぎりぎりの文書を組にして点数を出し、その平均を目安にします。
クエリ変換は質問と文書の言葉のずれを埋める
クエリ変換とは、質問をそのまま検索せず、言い換えや分解をしてから検索する手法です。利用者が「有給」と書き、規程が「年次有給休暇」と書くようなずれは、検索方式を変えても残ることがあります。
一方で検索回数とLLMの呼び出しが増え、意図と違う言い換えが混ざる危険もあります。ハイブリッド検索と再ランクで残った漏れを確かめてから足すのが安全です。
参照元:Microsoft Learn「ハイブリッド検索の概要」「セマンティック ランキングの概要」(2026年8月更新)/Cohere「Rerank Overview」「Best Practices for using Rerank」
RAGの精度を測る評価指標は検索側と生成側で分ける
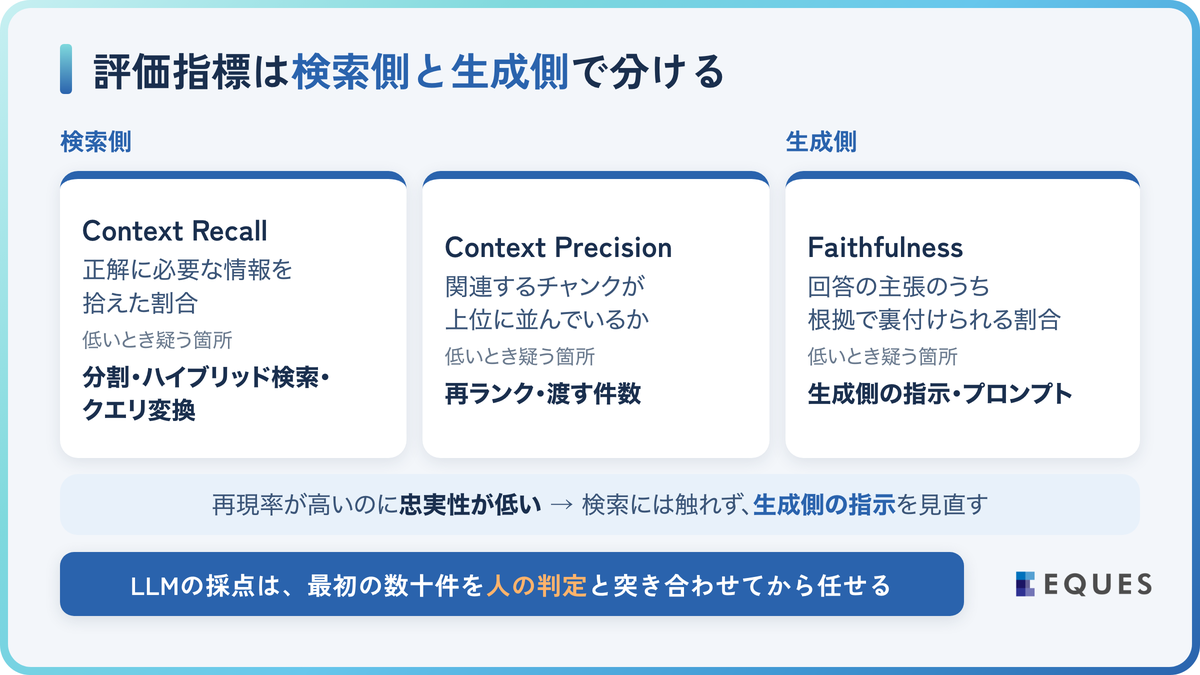
評価では、検索の当たり具合と回答の忠実さを別々の数値で測ることが改善の手掛かりです。回答の正誤だけでは、点数が下がっても検索の取りこぼしか生成の逸脱かを区別できず、直す場所を誤ります。
代表的な指標は、オープンソースの評価ライブラリRagasが定義する次の3つです。
| 指標 | 測るもの | 低いときに疑う箇所 |
|---|---|---|
| Context Recall | 正解に必要な情報を検索で拾えた割合 | 分割・ハイブリッド検索・クエリ変換 |
| Context Precision | 関連するチャンクが上位に並んでいるか | 再ランク・渡す件数 |
| Faithfulness | 回答の主張のうち根拠で裏付けられる割合 | 生成側の指示・プロンプト |
Faithfulness(忠実性)は0〜1で表し、Context Recallが高いのに忠実性が低いなら、生成側を直す合図です。
根拠は正しく拾えているのに回答に別の規程の条件が混ざる場合がこの形で、検索には触れず生成側の指示を見直します。
LLMが採点する方式を使う場合は、採点そのものに誤りが混ざる点に注意が必要です。最初の数十件は人の判定と突き合わせ、ずれを確かめてから自動評価に任せます。
採点の偏りへの対処は「ローカルLLMの評価方法|業務データで精度を測る5ステップと指標」で扱っています。
参照元:Ragas「Context Recall」「Context Precision」「Faithfulness」
RAG精度向上の改善の順番5ステップ
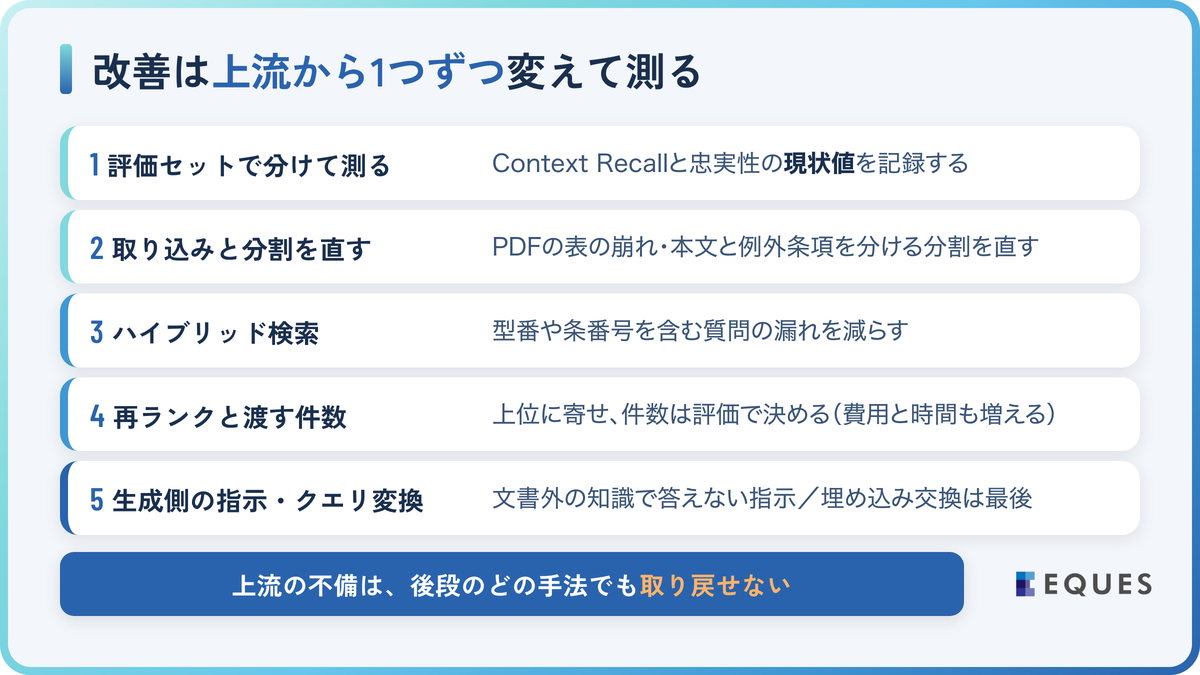
手法を一度に入れると、精度が上がっても下がっても、どれが原因か分からなくなります。弊社は、評価の土台を作り、上流から1つずつ変えて測る順番が最も手戻りが少ないと考えています。上流の不備は後段のどの手法でも取り戻せないためです。
たとえば分割で切れた例外条項は、再ランクやプロンプトをどれだけ調整しても回答に現れません。
1. 評価セットで検索と生成を分けて測る
最初に、現場の質問と外れやすい質問、正解の箇所を集め、Context Recallと忠実性の現状値を記録します。基準値がないまま手を入れると、改善したのか悪化したのかを判断できません。
質問の集め方や件数の目安は「RAG導入で精度が出ない3つの原因と改善手順【2026年版】」で解説しています。
2. 取り込みとチャンク分割を直す
検索側で外れる質問では、PDFの表の崩れや、本文と例外条項を分ける分割が原因になっていることがあります。分割は後段の手法の入力になるため、ここを飛ばして再ランクを足しても、候補に正解がなければ並べ直しようがありません。チャンクへの文脈付与も、この段階で試します。
3. ハイブリッド検索で取りこぼしを減らす
型番や条番号を含む質問の漏れは、キーワード検索を併用すると減らせます。Microsoftの比較でも併用は単独より高い値を示しており、追加の手間に比べて効果が大きいと考えられるため、分割の次に試す手法として適しています。
4. 再ランクで上位の質を上げ、渡す件数を決める
候補に正解が入ったら、再ランクで上位に寄せ、LLMに渡す件数を評価で決めます。Anthropicは5件・10件・20件を比べて20件が最も良かったと報告していますが、件数と再ランクの呼び出しが増えるほど費用と処理時間も増えます。
5. 生成側の指示とクエリ変換を調整する
検索が当たっているのに誤答が残る場合は、文書外の知識で答えない指示や根拠箇所の併記を加えます。言葉のずれによる漏れが残ればクエリ変換を足し、埋め込みモデルの入れ替えは全文書の再登録が要るため、それでも届かない場合に検討します。
生成側の対策は「ハルシネーション対策とは?原因と安全なAI活用法を徹底解説」で解説しています。
こうした改善を本番開発の前に小さく検証したい場合に向けて、弊社はAI PoCサービス「ココロミ」(スリムプラン月々99万円〜、スタンダードプラン月々250万円〜)を提供しています。
SOLIZE PARTNERS株式会社とのPoCでは、設計ナレッジの提案支援を含む2テーマを検証し、過去の資料を探す手間を減らせる見通しを得ました。
参照元:Anthropic「Introducing Contextual Retrieval」(2024年9月)/株式会社EQUES「SOLIZE PARTNERS 導入事例」
RAGの精度向上に関するよくある質問
Q. チャンクのサイズはどのくらいから試せばよいですか?
文書の構造と質問の粒度で変わります。まず見出し単位で切り、長い節だけを512トークン前後(Microsoftの検証で最も高い値だった設定)に分けたうえで、評価セットで2〜3通りを比べてください。
Q. ハイブリッド検索と再ランクはどちらを先に入れるべきですか?
型番や固有名詞の漏れが目立つならハイブリッド検索、正解は候補に入るが上位に来ないなら再ランクが先です。
Q. 古い版の文書が回答に混ざるときは?
旧版や重複文書が候補に残るためです。版や日付のメタデータで検索対象を絞ってください。
まとめ
RAGの精度向上は、原因の切り分けと評価から始め、上流から1つずつ直します。
- 正解の箇所が検索候補になければ検索側、あるのに誤答なら生成側の問題として扱う
- 検索側は分割と文脈付与で土台を整え、ハイブリッド検索・再ランク・クエリ変換で漏れを減らす
- Context Recall・Context Precision・忠実性を分けて測り、手法は1つずつ変えて確かめる
どこから直すべきか迷っている段階でも、お気軽にご相談ください。
RAGの精度改善を、評価の設計から相談しませんか
AI PoCサービス「ココロミ」はスリムプラン月々99万円〜・スタンダードプラン月々250万円〜の月額制です。まずは無料相談からどうぞ。