記事の要約
- RAGとは、社内文書などを検索してその内容をもとに生成AIに回答させる仕組みで、AIが知らない情報を扱えるようにする代表的な方法です。
- 精度が上がらない原因の多くはAIモデル側ではなく、元の文書を読み込む前処理と、検索の当て方にあります。
- 改善を進めるには、まず何が間違っていたのかを数値で特定できる評価の仕組みを用意することが先決です。
社内文書を読ませるRAGの仕組みを構築したものの、期待した答えが返ってこない。表の中の数値を聞くと的外れな回答が出る。現場から「結局、自分で探したほうが早い」と言われてしまう。
RAG導入の相談で最も多いのが、こうした「作れたのに使われない」という状態です。本記事は、RAGの作り方ではなく直し方に焦点を当てます。精度が出ない原因を前処理・検索方式・評価という3つの観点から切り分け、それぞれに何をすればよいかを具体的に示します。
あわせて、既存環境を活かしながら改善する現実的な進め方も解説します。読み終えるころには、自社のRAGのどこに問題があるのかを特定し、次の一手を決められるようになるはずです。
目次
RAG導入の現実|「作れたのに使われない」が起きる理由
RAG(Retrieval-Augmented Generation)とは、質問に関連する文書を検索し、その内容を根拠として生成AIに回答させる仕組みです。2020年に発表された研究で提案された手法で、モデル自体を学習し直すことなく、外部の知識を回答に反映できる点が利点とされています。
社内規程や製品仕様のようにAIが学習していない情報を扱う方法として、現在最も現実的な選択肢です。
ところが、実際に構築してみると精度が上がらないという相談が後を絶ちません。企業の生成AI活用が試験利用の段階にとどまり、全社的なサービスに組み込まれている企業が18.6%にすぎないという調査結果も、この停滞と無関係ではないでしょう。
重要なのは、この問題の原因がAIモデルの性能にあるケースが少ないという点です。より高性能なモデルに切り替えても、検索の段階で必要な文書が取れていなければ、出力は改善しません。RAGの精度は、検索の精度と前処理の質にほぼ規定されます。
ここを見誤ると、モデルの入れ替えを繰り返して時間と費用だけが消えていきます。
参照元:Lewis et al.「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(2020年)/独立行政法人情報処理推進機構(IPA)「DX動向2026」(2026年7月30日公表・2025年度調査)
RAGの精度が出ない3つの根本原因
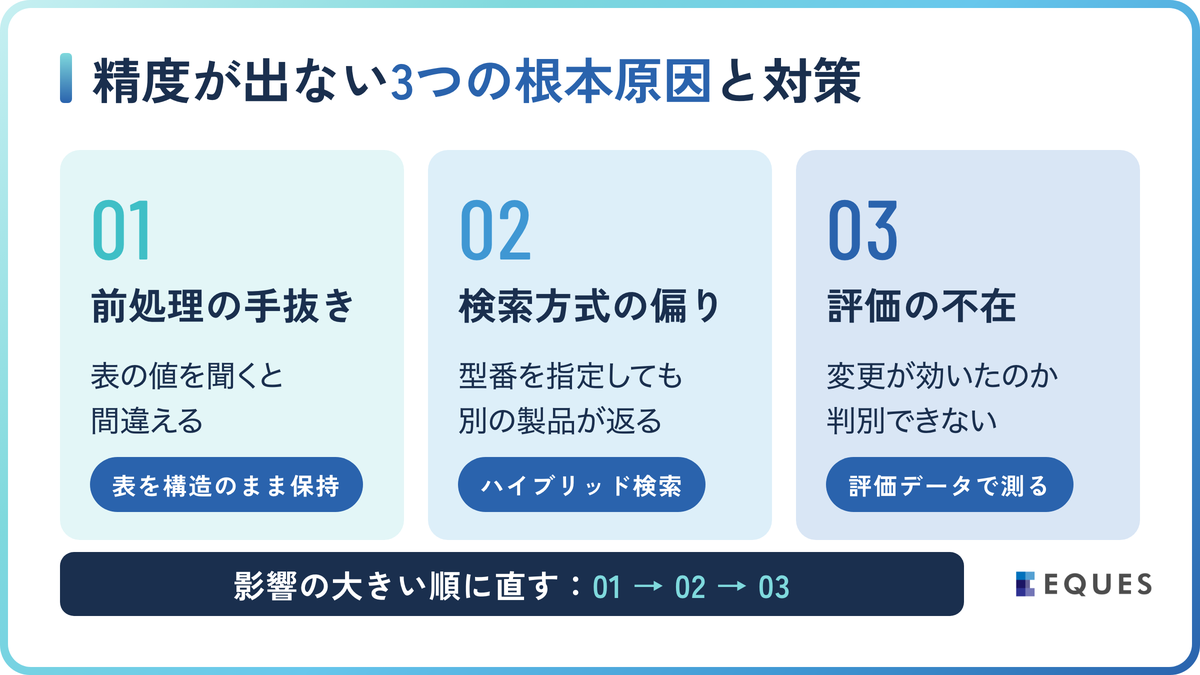
精度が出ない事例を分解していくと、原因はほぼ次の3つに集約されます。上から順に影響が大きく、下の対策を先に打っても効果が出にくいという関係にあります。
- 原因1:データ前処理の手抜きにより、元の文書が壊れた状態で取り込まれている
- 原因2:ベクトル検索への過信と、キーワード検索の欠如
- 原因3:感覚的な評価による、改善ループの迷走
原因1は、すべての元凶といえる前処理の問題です。社内文書の多くはPDFやWordで、表組みや段組み、ヘッダー・フッターを含みます。これらを単純にテキスト化すると、表は行と列の対応が失われてただの数字の羅列になり、2段組みの文書は左右の文がつながって意味不明な文章になります。
各ページのヘッダーやフッターが本文に混入し、検索の邪魔をすることも頻繁に起こります。この状態で取り込めば、どれだけ検索を工夫しても、そもそも正しい情報が存在しません。「表の中の値を聞くと間違える」という症状が出ている場合、原因はほぼここです。
対策は、レイアウトを解析して表を構造のまま保持できる読み取り処理を使うこと、そしてヘッダーやフッターを除去したうえで、文書を意味のまとまりで分割することです。取り込み後に、変換されたテキストを人が実際に読んで確認する工程を省かないでください。
原因2は、検索方式の偏りです。RAGの構築では、文章の意味の近さで検索するベクトル検索が広く使われます。
表現が違っても意味が近い文書を拾える点が強みですが、弱点もあります。型番や法令の条番号、社内の略称のように、意味ではなく文字列そのものが手がかりになる情報は取りこぼしがちです。「型番を指定して聞いたのに別の製品の説明が返る」という症状はこの典型です。
対策は、ベクトル検索と従来のキーワード検索を併用し、両方の結果を統合するハイブリッド検索に切り替えることです。
さらに、検索で取得した候補を関連度の高い順に並べ替える再ランキングの処理を加えると、回答に渡す文書の質が上がります。主要なクラウドの検索サービスはこれらの機能を標準で備えているため、追加開発なしに切り替えられる場合もあります。
原因3は、評価の不在です。「なんとなく良くなった気がする」で改善を進めると、変更が効いたのか偶然なのか判別できません。結果として、前回の変更を打ち消すような修正を重ね、改善ループが迷走します。
対策は、想定質問と正解の組を集めた評価用データセットを用意し、変更のたびに同じ質問で測ることです。
測る指標は2段階に分けてください。ひとつは検索の段階で、正解の文書が候補に入っていたかどうか。もうひとつは生成の段階で、回答が渡した文書の内容に忠実かどうかです。
この2つを分けると、悪いのが検索なのか生成なのかが切り分けられ、次に直すべき箇所が明確になります。
精度を上げる改善手順|どこから手を付けるか
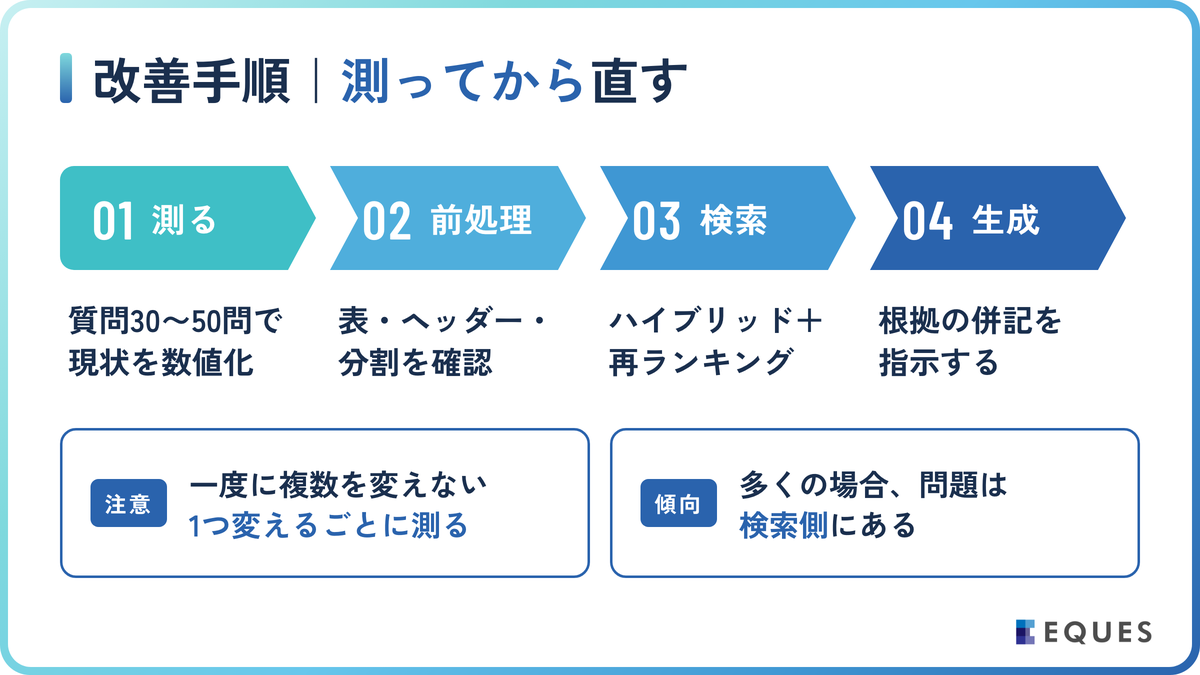
原因が分かっても、闇雲に手を付ければ改善は遠回りになります。前処理と検索を同時に触ってしまい、どちらが効いたのか分からなくなる例は非常に多く見られます。効率の良い順序は決まっていて、測る仕組みを整えてから直す、という進め方が結局は最短です。
ここでは、評価の用意から実際の改修までを2段階に分けて説明します。
まず測る|評価の仕組みを先に用意する
最初にやるべきは、改修ではなく現状の数値化です。現場の担当者に協力してもらい、実際に聞きたい質問を30問から50問程度集めます。それぞれについて、正解が書かれている社内文書と、期待する回答の要点を記録してください。
この作業は地味ですが、後の改善速度を決定づけます。評価データが揃えば、現状の正答率と、検索段階で正解文書を取得できている割合を測れます。
ここで「検索は当たっているのに回答が間違っている」のか「そもそも検索が外れている」のかが判明し、次の作業が決まります。多くの場合、問題は検索側にあります。
次に直す|前処理と検索を順に改善する
検索が外れている場合は、前処理から見直します。取り込んだテキストを実際に開き、表が崩れていないか、ヘッダーが混入していないか、文書が意味の切れ目で分割されているかを確認してください。ここを直すだけで改善する事例は少なくありません。
前処理を整えたうえで、キーワード検索を併用するハイブリッド構成に変更し、再ランキングを加えます。そのうえで再度評価を回し、数値の変化を確認します。
生成段階に問題がある場合は、渡した文書以外の知識で答えないよう指示を明確にする、根拠となった箇所を必ず併記させる、といった対応が有効です。
いずれの場合も、一度に複数を変更せず、1つ変えるごとに測ってください。
セキュリティとコストを踏まえたアーキテクチャ選定
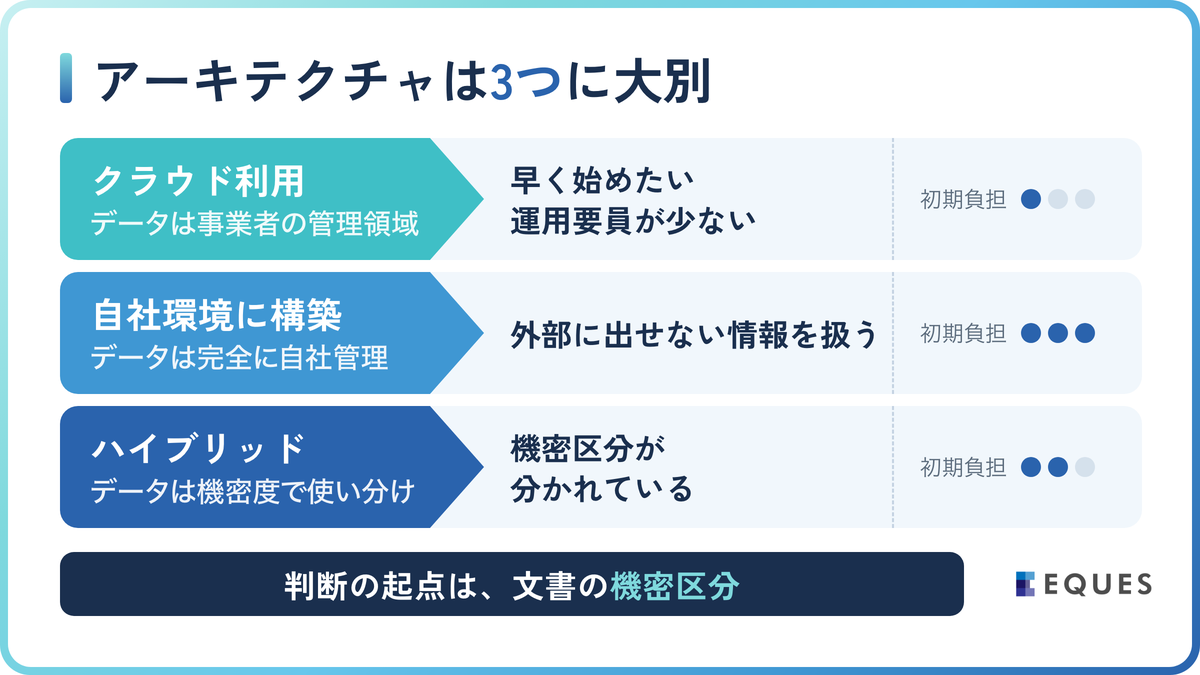
精度と並んで判断が必要になるのが、どこで動かすかという構成の選択です。選択肢は、クラウドのマネージドサービスを使う構成、自社環境に構築する構成、その中間となるハイブリッド構成の3つに大別できます。
| 構成 | データの所在 | 初期の負担 | 向いている状況 |
|---|---|---|---|
| クラウドのサービス利用 | 事業者の管理領域 | 小さい | 早く始めたい・運用要員が少ない |
| 自社環境に構築 | 完全に自社管理 | 大きい | 外部に出せない情報を扱う |
| ハイブリッド | 機密度で使い分け | 中程度 | 文書の機密区分が分かれている |
判断の起点になるのは、扱う文書の機密区分です。すべてを自社環境に置けば安全ですが、計算資源の調達と運用の負担が継続的に発生します。反対に、機密区分の整理をしないままクラウドに全文書を投入すると、後から取り出せない問題になりかねません。
実務的には、まず社内文書を機密度で分類し、外部に出せないものだけを自社環境で扱う構成が現実的です。
コスト面では、検索の実行回数と保存するデータ量が費用に直結するため、対象文書を絞ることが最も効果の高い削減策になります。
機密情報の扱いについては「生成AIで機密情報を扱うリスクとは?漏洩事例と安全な導入対策を徹底解説」もあわせてご覧ください。
RAG導入の事例|他社の取り組みと、既存環境を活かして改善する選択肢
RAGの導入は「作れたのに使われない」段階から、精度を測りながら業務に定着させる段階へ移りつつあります。公表されている国内企業の取り組みを見ると、最初から全社展開したのではなく、対象データを絞った試験運用から始め、段階的に範囲を広げている例が目立ちます。
ここでは3社の公表内容を紹介したうえで、すでにRAGを構築済みの企業に多い「作り直さずに中身だけ直す」という選択肢を説明します。
パナソニック コネクト:公開情報で試してから社外秘情報へ対象を拡大
パナソニック コネクトは、自社向けAIアシスタント「ConnectAI」で2024年4月から社外秘情報を対象にした活用を始めました。
2023年9月に公開情報(ウェブページ約3,700ページ・ニュースリリース495ページなど)を対象に試験運用を行い、その後、品質管理に関する社外秘情報630件・11,743ページへ対象を広げたと2024年6月に公表しています。
同社は2025年7月に、2024年の年間削減時間が44.8万時間で前年の2.4倍になったことも発表しました。公開情報で試してから機密情報へ進むという順序と、削減時間という指標で効果を追い続けている点が参考になります。
JR東日本:内製RAGのプロトタイプを現場で検証
JR東日本は、社内組織が内製したRAGシステムのプロトタイプを2023年11月から一部箇所で試使用し、2024年10月からの全社試使用を予定していると2024年7月に発表しました。
登録した社内文書に基づいて回答を生成する仕組みで、アジャイル開発により社内の意見を継続的に取り入れながら本導入へ進めるとしています。あわせて、鉄道事業固有の情報を学習した「鉄道版生成AI」の開発を進めることも公表されています。
汎用の生成AIチャットを全社員に展開したうえで、業務固有の質問に答える仕組みを別に内製している点は、本記事で述べた汎用モデルの限界への現実的な対応です。
旭化成:過去事例を読み込ませた生成AIで技術伝承
旭化成は2024年12月、製造現場の技術伝承において、過去事例のデータを読み込ませた生成AIの活用を開始したと発表しました。
経験の浅い従業員でも抜け漏れなくリスクと対応策を洗い出せるようになったとしており、社内に蓄積された文書を生成AIに参照させて答えさせるという点で、RAGと同じ考え方に立つ取り組みです。
過去の文書がそのまま学習・参照の対象になるため、本記事の原因1で述べた前処理の品質が成果を左右する典型的な用途といえます。
参照元:パナソニック コネクト「パナソニック コネクト 生成AI導入1年の実績と今後の活用構想」(2024年6月25日)/「パナソニックコネクト、「聞く」から「頼む」へシフトしたAI活用で年間44.8万時間の削減を達成」(2025年7月7日)/東日本旅客鉄道「生成AIチャットの全社員展開及び生成AIの内製開発について」(2024年7月11日)/旭化成「生成AIを新規用途探索の自動化や製造現場の技術伝承において活用開始」(2024年12月9日)
既存のRAG環境を作り直さずに改善する選択肢
すでにRAGを構築している企業から多くいただくご相談が、「環境を作り直さずに、中のロジックだけを改善したい」というものです。実際、精度の問題はインフラ構成ではなく前処理と検索の設計に起因することが大半であるため、既存の環境を維持したまま改善できる場合がほとんどです。
作り直しを前提とした提案を受けている場合は、本当に必要なのかを一度確認することをおすすめします。
弊社は東京大学松尾研発のスタートアップとして、こうした改善を伴走型で支援しています。
文書のテキスト化という前処理の領域では、細胞・遺伝子治療分野のCDMOであるCyto-Factoに対し、機器の画面を読み取ってデータ化するAI-OCRの開発を提供し、サンプル画像で100%の認識精度を達成しました。読み取りの品質がその後のすべてを決めるという考え方は、RAGの前処理にも共通します。
まずは現状の課題を整理したいという段階であれば、AI・DXに関する困りごとを東大出身のAI専門家集団がチャットで解決する「AI×DX寺子屋」をご利用いただけます。
プランAは月額20万円で相談し放題、月1回のオンラインミーティングが付きます。改善の効果を検証したうえで本格的に進めたい場合は、AI PoCサービス「ココロミ」もご用意しています。
RAGを含むローカルLLMの構築については「情報漏洩を防ぐ「ローカルLLM」開発の全貌|要件・RAG構築・導入ステップまで徹底解説」で詳しく解説しています。
参照元:株式会社EQUES「AI-OCRで製造現場の記録を自動化|Cyto-Factoの導入事例」
RAG導入に関するよくある質問
Q. PDFの表や図を正しく読み取るにはどうすればよいですか?
レイアウトを解析し、表を構造のまま抽出できる処理を使う必要があります。単純なテキスト抽出では行と列の対応が失われます。読み取った結果を人が確認する工程を設けることも欠かせません。
Q. モデルを高性能なものに変えれば精度は上がりますか?
検索段階で正解の文書が取得できていない場合、モデルを変えても改善しません。まず検索の成否を測り、原因が生成側にあるのか検索側にあるのかを切り分けてください。
Q. 評価用のデータはどのくらい用意すべきですか?
はじめは30問から50問程度で十分に傾向が見えます。重要なのは件数より、現場が実際に聞きたい質問で構成することです。
Q. 既存のクラウド環境を使い続けたまま改善できますか?
多くの場合は可能です。精度の問題は前処理と検索設計に起因することが大半で、環境の作り直しが必要になるのは、機密区分の要件が変わった場合などに限られます。
まとめ
RAG導入がうまくいかないとき、原因はAIモデルではなく、その手前の工程にあります。文書が壊れた状態で取り込まれていないか、検索の方式が偏っていないか、そして改善の効果を測れているか。
この3点を順に確認することが、遠回りに見えて最短の道です。本記事の要点は次のとおりです。
- 精度を決めるのは前処理と検索であり、モデルの入れ替えでは解決しない
- ベクトル検索だけに頼らず、キーワード検索を併用し再ランキングを加える
- 改善は測ることから始める。検索段階と生成段階を分けて評価すれば、直すべき箇所が特定できる
現在のRAGのどこに問題があるのか分からないという段階でも、評価の設計からご一緒できます。お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
RAGの精度にお困りの方へ
作り直さずに前処理と検索を直す。評価の設計から改善までご一緒します。
RAGでも残る誤回答(ハルシネーション)の原因と対策は、ハルシネーション対策を解説した記事で詳しく扱っています。