記事の要約
- ハルシネーション検出とは、生成された回答ごとに誤りの疑いを見つける仕組みで、発生率を下げる対策とは役割が異なります。
- 手法は根拠との照合・複数回生成の一致・判定モデル・人の確認の4つで、見つけられる誤りの種類とコストがそれぞれ違います。
- 誤りが外に出たときの影響の大きさに応じて手法を組み合わせ、しきい値(=判定を分ける基準の値)を「通す・確認に回す・止める」の3段で決め、判定結果をログに残して見直します。
「RAGもプロンプトも整えたのに、社内FAQボットの誤答に利用者の指摘で初めて気づいた」。検出の仕組みがないと、誤りは誰かが見つけるまで残り続けます。
本記事では、ハルシネーション検出の方法を4つに分け、論文と公式ドキュメントをもとに比較します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社の経験も踏まえて解説します。
目次
ハルシネーション検出とは?対策だけでは足りない理由
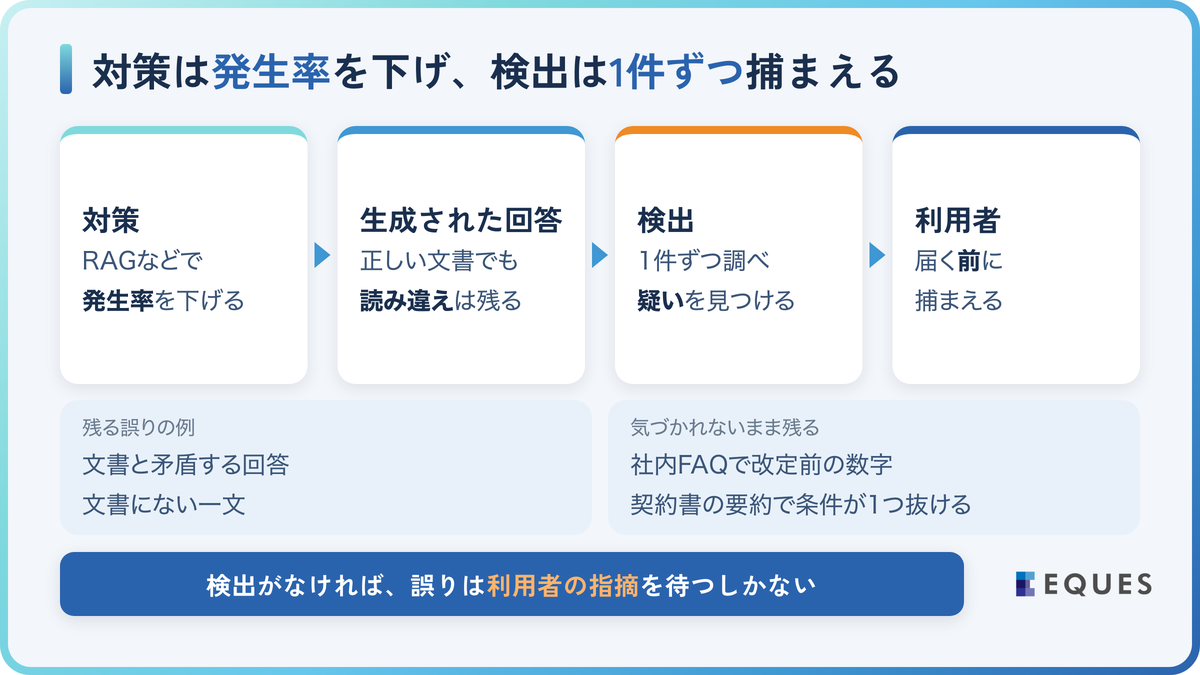
ハルシネーション検出(検知)とは、生成された回答を1件ずつ調べ、誤りの疑いがあるものを見つける仕組みです。発生率を下げる「対策」とは役割が異なり、起きた誤りを利用者に届く前に見つけます。
対策だけで足りない理由は、正しい文書を渡しても、モデルが読み違えたり補ったりするためです。RAG(=文書を検索し、その内容を根拠に答えさせる仕組み)を使っても、文書と矛盾する回答や文書にない一文は残ります。
この誤りはもっともらしい文体で出るため、読み手は気づきにくくなります。社内FAQで改定前の数字が返る、契約書の要約で条件が1つ抜ける、といった誤りは、検出の仕組みがなければ利用者の指摘を待つしかありません。
対策と検出を別の設計項目として扱うことをおすすめします。検出があれば、対策の効果も疑いの件数の増減で測れます。
原因と対策は「ハルシネーション対策とは?原因と安全なAI活用法を徹底解説」、実際に起きた誤りは「ハルシネーションの事例7選|企業・団体で起きた原因3型と対策」で解説しています。
ハルシネーション検出の4つの手法|仕組みと見つけられる誤り
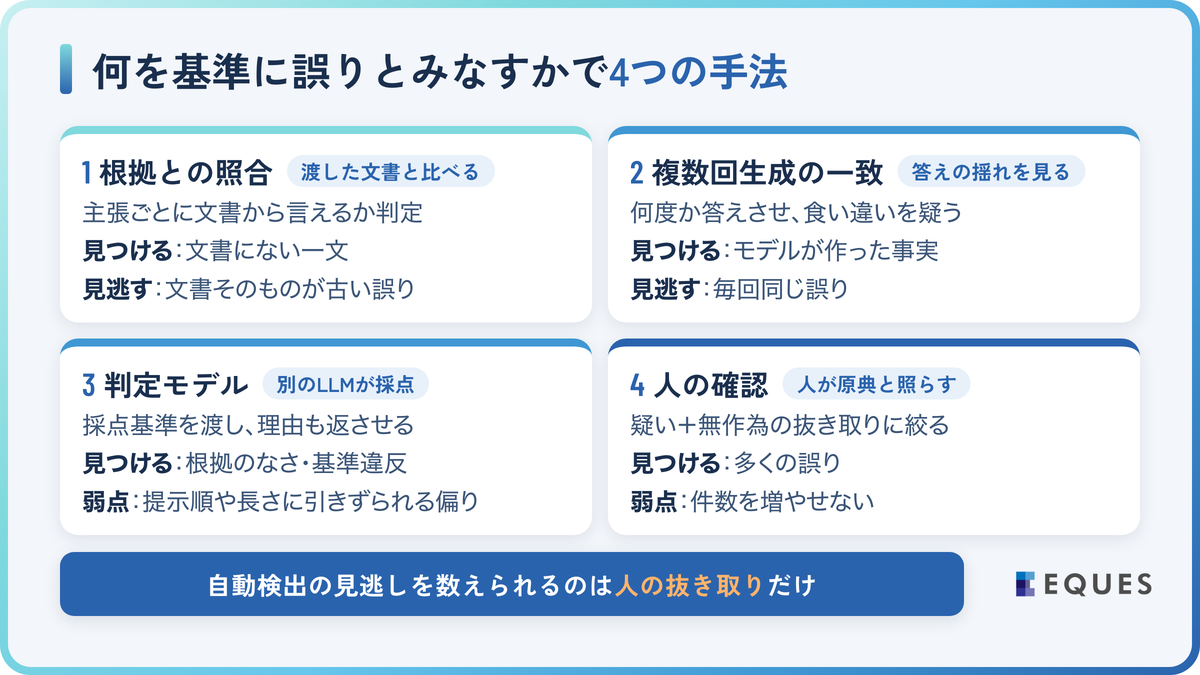
検出の手法は、何を基準に「誤り」とみなすかで4つに分かれます。渡した文書と比べるか、モデル自身の答えの揺れを見るか、別のLLM(=大規模言語モデル。文章を生成するAIの本体)や人の目で採点するかの違いです。
このほか、トークン確率(=モデルが各語を選んだときの確からしさ)の低さや、モデル内部の状態から誤りの疑いを推定する手法もあります。どちらもモデル内部の数値を扱う開発側の手法のため、本記事では業務担当も設定に関われる4つを扱います。
1. 根拠との照合(NLI・Faithfulness)
根拠との照合は、回答を短い主張に分け、各主張が渡した文書から言えるかを判定する手法です。判定にはLLMや、含意(=一方の文から他方が言えること)を判定する分類モデル(NLI=自然言語推論など)を使います。
代表的な指標は、評価ツールRagasのFaithfulnessで、文書に裏付けられた主張の割合を0〜1で表します。文書にない一文を足す誤りに強い一方、検索で改定前の規程が渡された場合のように、文書そのものが古い誤りは検出できません。
2. 複数回生成の一致(SelfCheckGPT・意味的エントロピー)
複数回生成の一致は、同じ質問に何度か答えさせ、回答どうしが食い違う箇所を誤りの疑いとみなす手法です。知っている事実は毎回同じように出て、知らない事実は生成のたびに変わる性質を利用します。
SelfCheckGPT(Manakulら、2023年)は外部文書なしで検出できます。意味的エントロピー(=回答の意味のばらつき)を測る手法(Farquharら、Nature、2024年)は、10回の生成を意味ごとにまとめて不確かさを測ります。
弱点は、毎回同じ誤りを答える場合には検出できない点で、Nature論文もこの限界を明記しています。生成回数の分だけ費用と待ち時間も増えます。
3. 判定モデル(LLM-as-a-judge)
判定モデルは、別のLLMに採点基準を渡し、根拠のない記述がないかを判定させる手法です。LLM-as-a-judge(=LLMに採点役をさせる方法)と呼ばれ、判定理由を文章で返せるため原因調査に役立ちます。
GPT-4の判定は80%超で人の評価と一致した一方、提示順や回答の長さに引きずられる偏りも報告されています(Zhengら、2023年)。判定役のLLMも文章の見た目から点を付けるため、長い回答や先に示した回答を高く採点しやすくなります。
そのため、判定役も誤る前提で人の確認と組み合わせることが欠かせません。判定理由を人が抜き取りで確かめれば、偏った採点に気づけます。偏りの抑え方は「ローカルLLMの評価方法|業務データで精度を測る5ステップと指標」で扱っています。
4. 人の確認(抜き取りとエスカレーション)
人の確認は、担当者が原典と照らして判定する、誤りを拾いやすい一方で最も高くつく手法です。多くの業務で全件は現実的でないため、自動検出で疑いが出て人に引き継ぐ回答(エスカレーション)と、無作為に抜き取った回答に絞ります。抜き取りを残すのは、自動検出の見逃しを数える手段が人の確認しかないためです。
参照元:Manakul et al.「SelfCheckGPT」EMNLP 2023(2023年12月)/Farquhar et al.「Detecting hallucinations in large language models using semantic entropy」Nature(2024年6月)/Ragas「Faithfulness」(2026年11月確認)/Zheng et al.「Judging LLM-as-a-Judge」NeurIPS 2023(2023年12月)
検出手法の比較表とクラウド3社の検出機能
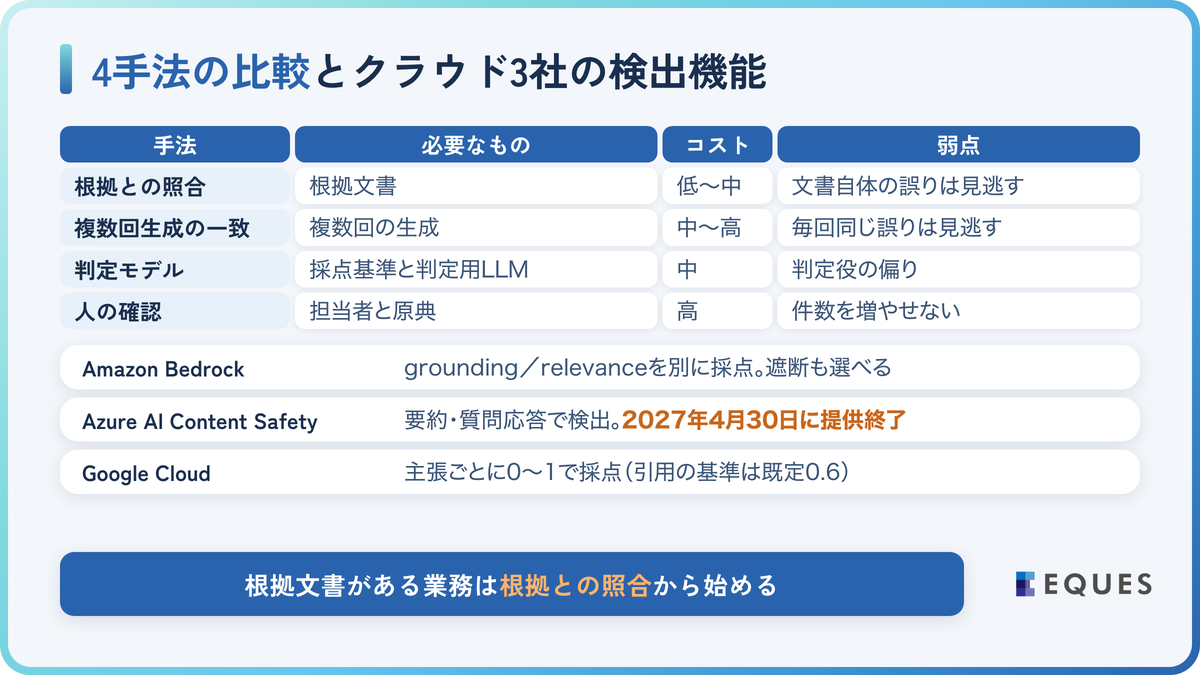
4つの手法は、見つけられる誤りと必要なものが重ならないため、1つで全てを賄えません。ハルシネーションの評価方法を選ぶ前に、検出対象・必要なもの・コスト・弱点の4軸で比べます。
| 手法 | 検出対象 | 必要なもの | コスト | 弱点 |
|---|---|---|---|---|
| 根拠との照合 | 文書との矛盾、文書にない記述 | 根拠文書 | 低〜中 | 文書自体の誤りは見逃す |
| 複数回生成の一致 | モデルが作った事実 | 複数回の生成 | 中〜高 | 毎回同じ誤りは見逃す |
| 判定モデル | 根拠のなさ、基準違反 | 採点基準と判定用LLM | 中 | 判定役の偏り |
| 人の確認 | 多くの誤り | 担当者と原典 | 高 | 件数を増やせない |
根拠文書がある業務では根拠との照合が始めやすいというのが弊社の見方です。根拠文書のない質問には複数回生成の一致を、社内基準への適合まで見るなら判定モデルを足す、という順で選びます。
根拠との照合は、主要クラウドがマネージド機能(=クラウド側が運用する完成済みの機能)として提供しており、自前で照合用のモデルを用意せずに始められます。
3社とも、回答が渡した文書からどこまで言えるかを採点し、しきい値を下回る回答や箇所を返す点は共通です。違いは採点の単位と、結果を回答の遮断に使うか確認の印に使うかです。
1. Amazon Bedrock Guardrails:contextual grounding check
回答が根拠に基づくか(grounding)と、質問に答えているか(relevance)を別々にスコア化します。しきい値は0〜0.99の範囲で設定します。
遮断するか判定情報だけ返すかを選べるため、顧客対応チャットは遮断し、社内FAQは判定情報を注意書きに使う、と分けられます。
日本語に対応するのは既定のClassic tier(tier=区分)ではなくStandard tierで、クロスリージョン推論(=複数地域のサーバーで処理を分け合う方式)が前提のため、使えるリージョンも限られます。
根拠文書は10万字、回答は5,000字までのため、長い契約書は分割して渡します。
2. Azure AI Content Safety:groundedness detection
要約と質問応答の2種類のタスクで根拠にない記述を検出します。判定理由の説明や自動修正(プレビュー=正式提供前の試験版)、医療分野向けの設定も備えます。英語以外も送信できますが、精度は英語向けに最適化されています。
また、2027年4月30日に提供終了と告知されています。提供終了が決まっているため、新規の設計では比較の候補にとどめ、代替として案内されているFoundryの評価機能や、自前で組む根拠との照合も比べます。
3. Google Cloud:check grounding API
根拠の強さを0〜1のサポートスコアで返し、主張(文)ごとに裏付けの有無を示すため、人が確認する箇所を絞れます。引用とみなす基準の既定値は0.6で、Agent SearchのRAG機能の一部として提供されています。契約書レビューなら、裏付けのない主張を、法務が確認する箇所の印に使えます。
参照元:Amazon Web Services「Use contextual grounding check」「Languages supported by Amazon Bedrock Guardrails」(2026年11月確認)/Microsoft「Groundedness detection」(2026年10月更新)/Google Cloud「Check grounding」(2026年11月確認)
業務別のハルシネーション検出の組み合わせ方
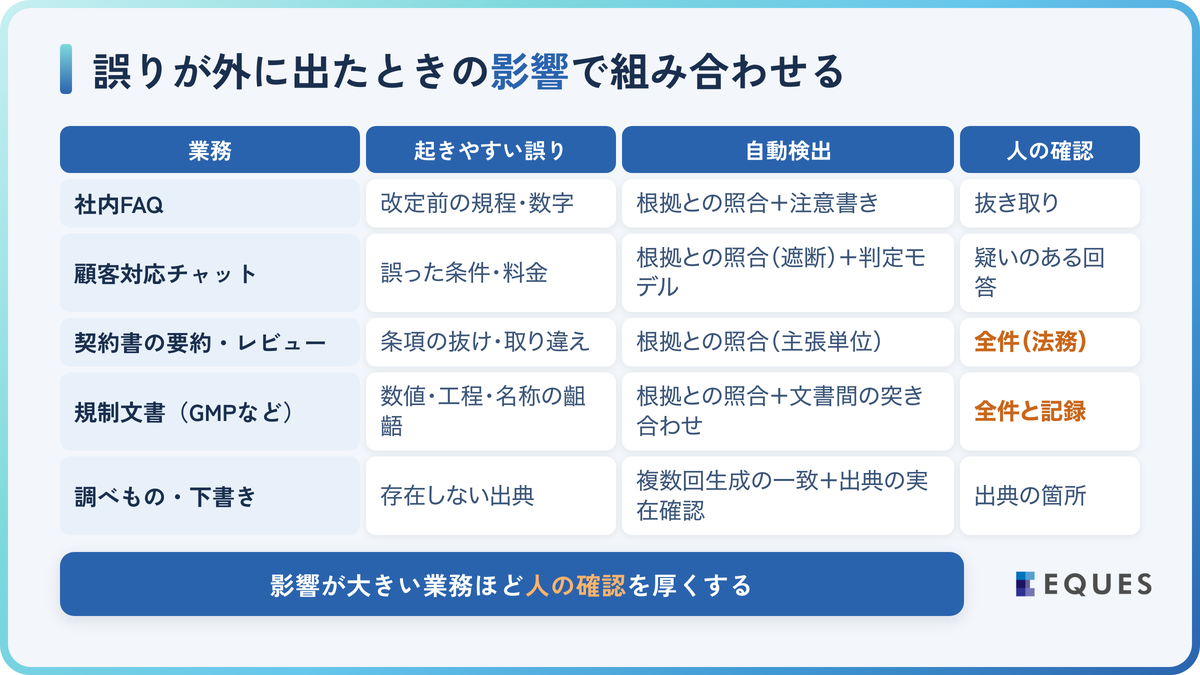
組み合わせは、誤りが外に出たときの影響の大きさで決めます。影響が小さい業務は自動検出を中心に運用し、影響が大きい業務ほど人の確認を厚くします。
| 業務 | 起きやすい誤り | 自動検出 | 人の確認 |
|---|---|---|---|
| 社内FAQ | 改定前の規程・数字 | 根拠との照合+注意書き | 抜き取り |
| 顧客対応チャット | 誤った条件・料金 | 根拠との照合(遮断)+判定モデル | 疑いのある回答 |
| 契約書の要約・レビュー | 条項の抜け・取り違え | 根拠との照合(主張単位) | 全件(法務) |
| 規制文書(GMP文書など) | 数値・工程・名称の齟齬 | 根拠との照合+文書間の突き合わせ | 全件と記録 |
| 調べもの・下書き | 存在しない出典 | 複数回生成の一致+出典の実在確認 | 出典の箇所 |
社内FAQでは、疑いの出た回答に注意書きを付けることも一つの手です。利用者が原典を確かめるきっかけになり、誤りが気づかれないまま広がる事態を防げます。
契約書や規制文書(GMP=医薬品の製造・品質管理の基準)では、検出は確認者が見る箇所を絞る道具と位置づけます。人の確認を減らしすぎると、検出器(=自動検出の仕組み)の見逃しがそのまま通るためです。
根拠との照合の精度は渡す文書の質に左右されます。検索の直し方は「RAG導入で精度が出ない3つの原因と改善手順【2026年版】」をご参照ください。
ハルシネーション検出を運用に組み込む型|しきい値・ログ・見直し
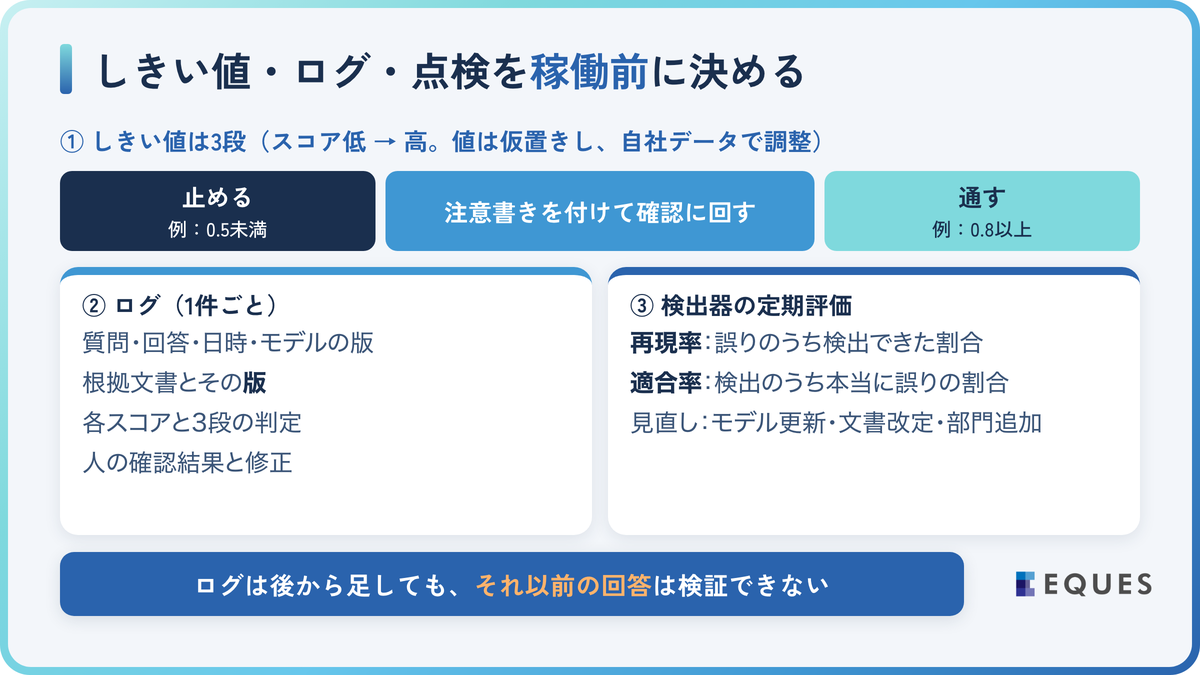
LLMの出力を検証する仕組みは、入れた時点ではなく、運用で数字を見直し続けて初めて機能します。モデルの更新や文書の改定で回答の傾向は変わり、導入時に合わせた設定もずれていくためです。
しきい値・ログ・検出器の点検の3点は、稼働前に決めておきます。ログは後から足しても、それ以前の回答を検証できません。
しきい値は「通す・確認に回す・止める」の3段で決める
しきい値を1つだけ設けると、厳しくすれば正しい回答まで止まり、緩めれば誤りが通ります。そこでスコアの高い順に「通す」「注意書きを付けて確認に回す」「止める」の3段で運用します。
値は、例として「0.8以上は通す、0.5未満は止める」のように仮置きし、自社データで調整します。仮置きから始めるのは、正誤を付けた自社の回答が集まるまで、止めすぎと通しすぎが釣り合う値が分からないためです。
AWSもStandard tierの会話用途では0.7を出発点に挙げ、tierを変えるときは自社データでしきい値を試すよう求めています。
調整では、正誤を付けた回答で「止めた正しい回答」と「通した誤り」を数えます。どちらを減らすかは業務で決まり、法務や規制文書では通した誤りを減らす側に寄せます。
ログに残す項目:入力・根拠・スコア・最終判断
ログは、誤りが見つかったときに「どこで間違えたか」をたどれる細かさで残します。次の項目を1件ごとに記録します。
- 質問文と回答文、日時、モデルと設定の版
- 渡した根拠文書とその版
- 各手法のスコアと3段の判定結果
- 人の確認結果と修正内容
文書の版まで残すのは、原因が「モデルの読み違い」か「文書の古さ」かを切り分けるためです。原因を取り違えると直す場所を誤ります。個人情報を含む業務では、ログの閲覧権限と保存期間も先に決めます。
検出器そのものを定期的に評価する
検出器も誤るため、抜き取りで人が付けた正誤と検出器の判定を定期的に突き合わせます。見る数字は、誤りのうち検出できた割合(再現率)と、検出のうち本当に誤りだった割合(適合率)の2つです。止める範囲を広げると再現率は上がり、適合率は下がりやすくなります。
見直しの目安は、モデルの更新、根拠文書の改定、利用部門の追加です。前の設定のまま運用すると、見逃しが増えても気づきにくくなります。
しきい値や確認の流れを本番前に確かめる場として、弊社はAI PoC(=本番前に小さく行う技術検証)サービス「ココロミ」(スリムプラン月々99万円〜、スタンダードプラン月々250万円〜)を提供しています。
製薬の品質保証向けには、承認書や製造手順書など複数文書の齟齬を段落単位で自動検出する「QAI Checker」もあり、根拠との照合を文書確認に組み込む選択肢になります。
ハルシネーション検出に関するよくある質問
Q. ハルシネーションを自動で完全に検出できますか?
できません。見逃しはゼロにならないため、自動検出で疑いを絞り、重要な業務では人の確認を残します。
Q. RAGを使っていれば検出は不要ですか?
不要にはなりません。文書の読み違いは残るためです。むしろRAGは根拠文書が手元にあるので、根拠との照合を低コストで組み込めます。
Q. 検出の仕組みづくりは誰が担うべきですか?
開発者に、業務担当と法務・品質保証の担当が加わる体制が望ましいといえます。どの誤りをどこまで許すかは業務判断だからです。
まとめ
ハルシネーション検出は、起きた誤りを利用者に届く前に見つける仕組みです。要点は次のとおりです。
- 4つの手法は検出対象とコストが異なり、1つでは見逃しが残る
- 根拠文書がある業務では根拠との照合が基本で、契約書や規制文書では人の確認と組み合わせる
- しきい値は3段で決め、判定をログに残し、検出器も定期的に評価する
ハルシネーション検出の設計を検討している段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
ハルシネーション検出の設計を、本番前に検証しませんか
AI PoCサービス「ココロミ」はスリムプラン月々99万円〜・スタンダードプラン月々250万円〜の月額制です。まずは無料相談からどうぞ。