記事の要約
- 異常検知AIとは、データの中から「いつもと違う」ものを見つけるAIで、代表的なのは正常なときのデータだけで「いつもの状態」を学び、外れ具合を異常度で示す方式です。
- 教師なし学習は正常データだけを、教師あり学習は正常と不良に正解のラベルを付けたデータを学習に使うため、不良品データが少ない現場では教師なし学習から始めます。
- 異常検知AIが現場に定着しないのは、不良品データが少ない、季節やロットで条件が変わる、判定の根拠が求められる、という製造現場の実情に合っていないときです。
「設備の故障の兆しを、AIで早くつかめないか」「目視検査の負担を、AIで減らせないか」。設備保全や品質管理を担当していて、こうした検討を任された方もいるのではないでしょうか。
しきい値によるアラームや目視検査はすでに現場で回っていても、AIがどうやって「いつもと違う」を見分けるのか、どの手法を選べばよいのかは見えにくいものです。導入はしたものの、「誤検知が多く現場が使わなくなった」と悩んでいる担当者もいるでしょう。
本記事では、異常検知AIの仕組みを具体的な場面で説明し、手法の選び方、国内5社の導入事例、失敗しない進め方までを、東京大学松尾研発のAIスタートアップとして製造業のAI開発を支援してきた弊社の視点で解説します。読み終える頃には、自社の設備やラインにどの手法が合うのか、判断の軸が定まっているはずです。
目次
異常検知AIとは?従来の検査手法との違い
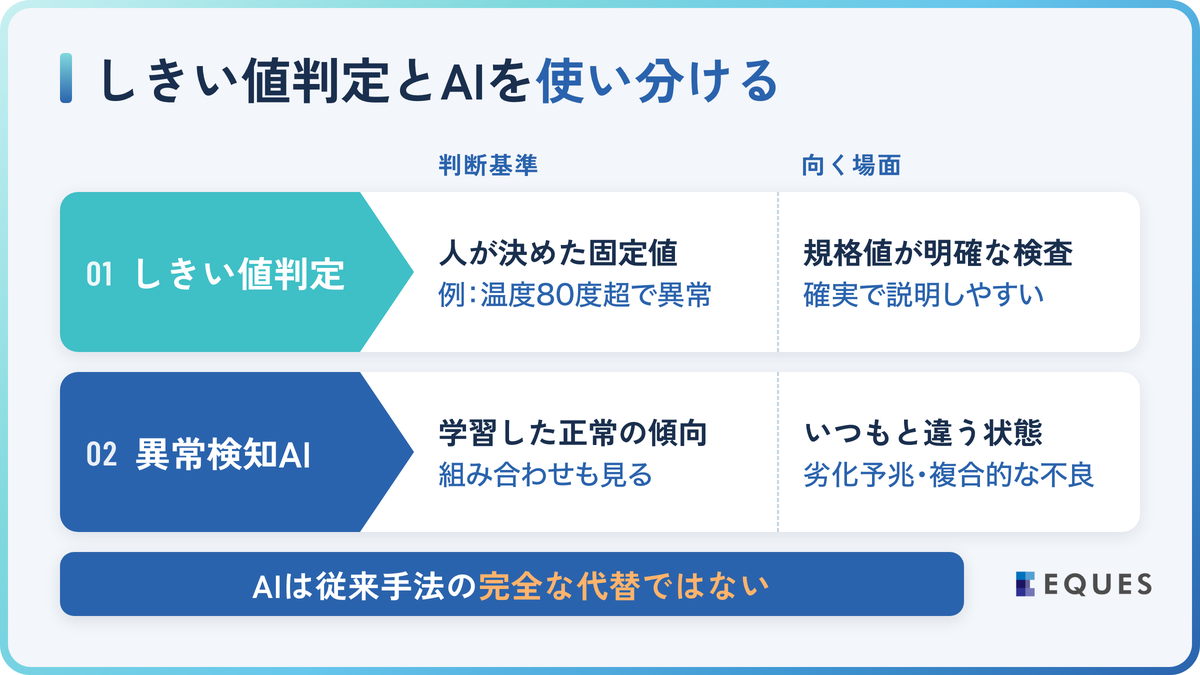
異常検知AIとは、データの中から「いつもと違う」ものを見つけ出すAIです。代表的なのは、設備や製品が正常なときのデータだけを学習させ、「いつもの状態」からどれだけ外れているかを数値で示す方式で、本記事でもまずこの方式から説明します。「温度が80度を超えたら異常」のように人が決めた固定値で項目を一つずつ見るしきい値判定に対し、異常検知AIは、データから覚えた「いつもの状態」との違いで判定します。
この違いが効くのは、どのような場面でしょうか。例えば、負荷が高いときほど振動が大きくなるモーターを、振動値のしきい値で監視しているとします。しきい値は、高負荷のときの普段の振動で警報が鳴らないよう、高めに置くしかありません。そのため、軸受が傷み始めて軽負荷のときの振動が普段より大きくなっても、値はしきい値の下にとどまり、警報は鳴りません。
異常検知AIは、こうした項目どうしの関係を「いつもの状態」として覚えます。正常に動いていた期間の電流(負荷の大きさ)を横軸、振動を縦軸にとって点を打つと、点は右上がりの帯のように並びます。新しいデータの点がこの帯から離れるほど、AIは「いつもと違う」度合いを表す数値、つまり異常度を高く出します。軽負荷なのに振動が大きい点は、しきい値より低くても帯から外れるため、異常度が上がるのです。
最後に異常度に線を引いて警報を出す点は、しきい値監視と同じです。違うのは、線を引く対象が、センサーの値そのものから「いつもとの違いの大きさ」に変わることです。
この方式でAIに見せるのは、正常なときのデータだけです。故障したときのデータを用意しなくてよいため、過去に経験したことのない故障でも、いつもと違えば異常度が上がります。その代わり、AIが示すのは「いつもと違う」までで、原因が軸受の傷か、運転条件の変化かを見分けるのは人の役目です。
カメラ画像を使う外観検査でも、考え方は同じです。人が「黒い点が一定の大きさを超えたら不良」のように条件を書き出すルールベースの検査と違い、良品の画像を学習したAIは、良品の見た目から外れたところを拾います。そのため、条件に書いていなかった種類の傷や汚れも検出できる場合があります。
ただし、異常検知AIは、しきい値判定や目視検査の完全な代替ではありません。寸法や安全上の上限のように規格値がはっきりしているものは、しきい値判定のほうが確実で、判定の理由も説明しやすいからです。AIが力を発揮するのは、劣化の予兆や複数の条件が重なる不良など、規格値では書き表しにくい「いつもと違う状態」を捉えたい場面です。既存のしきい値監視は残し、その手前の変化をAIで拾う形で組み合わせます。
異常検知AIの主要な手法と選び方
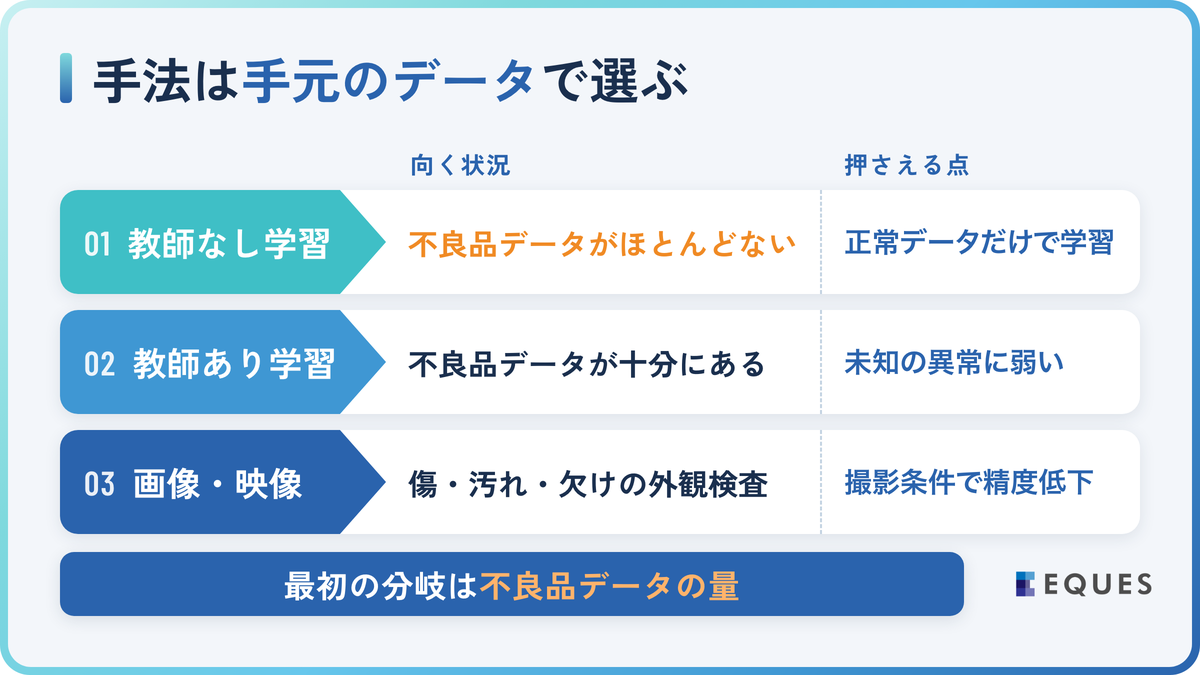
異常検知AIの手法は、学習のときにAIに何を見せるか(正常データだけか、正常と不良の両方か)と、扱うデータの種類(センサーの数値か、画像か)の2つの軸で整理すると選びやすくなります。最初の分岐は、不良品のデータがどれだけあるかで、これで1つ目の軸が決まります。
正常データだけを見せる方式は教師なし学習と呼ばれ、前の章で説明した仕組みがこれにあたります。一方、正常と不良の両方に「これは正常」「これは傷」「これは異物」といった正解の札(=ラベル)を付けて見せ、両者を分ける境目を覚えさせる方式が教師あり学習です。「教師」とは、この正解の札のことです。
不良が年に数回しか出ない工程や、故障の経験が少ない設備の予兆監視では、教師あり学習に見せる不良の例がそろわないため、教師なし学習が現実的です。不良の種類ごとに記録と写真がそろっているなら、教師あり学習も選べます。2つ目の軸では、振動や電流などの数値と外観検査の画像とで使う手法が変わり、組み合わせると次のようになります。
| 学び方 | センサーの数値(振動・電流・温度など) | 画像(外観検査) |
|---|---|---|
| 正常データのみで学ぶ(教師なし学習。不良のラベルは不要) | 設備の予兆監視に向く。T²法、Isolation Forest、One-Class SVM、オートエンコーダなど | 良品の画像だけで傷・汚れ・欠けを拾う。照明や角度が変わると精度が落ちる |
| 正常と不良の両方で学ぶ(教師あり学習。ラベルが必要) | 繰り返し起きる不良や故障を種類まで見分ける。学習していない種類の不良は見逃しやすい | 不良の種類ごとに画像を学ばせて見分ける。不良画像の収集とラベル付けが要る |
迷ったときは、教師なし学習から始め、不良の記録がたまったら教師あり学習を加えるのが現実的です。AIが知らせた「いつもと違う」を現場で確かめ、「軸受の傷だった」「段取り替えの影響だった」と記録していけば、その記録がそのまま正解の札付きのデータになるからです。こうして、よく出る不良は教師あり学習で種類まで見分け、初めての不良は教師なし学習で拾う、という役割分担ができます。
教師なし学習:正常データだけで学習する
教師なし学習の手法は、どれも正常データのまとまりから新しいデータがどれだけ離れているかを測ります。違うのはその測り方で、代表的な4つは次のとおりです。
- ホテリングのT²法:正常データの平均からの離れ具合を、「負荷が上がれば振動も上がる」といった項目どうしの連動を踏まえて測ります。どの項目が効いたかを示せるため、判定理由を説明しやすい手法です
- Isolation Forest:データの範囲にランダムな区切りを入れていくと、ほかから離れたデータほど早く1つだけ切り離されます。この切り離しやすさを異常度にする手法で、計算が軽く、項目やデータ量が多い場合に向きます
- One-Class SVM:正常データを囲む境界線を学習し、外側を異常とみなします。境界を決める設定の調整に経験を要します
- オートエンコーダ:データを圧縮して元に戻す練習を正常データだけで行わせるため、見たことのない形はうまく元に戻せず、そのずれを異常度にします。振動の波形や画像のような複雑なデータに向きます
選び方の目安は、扱うデータと、判定理由をどこまで説明する必要があるかです。温度や電流のようなセンサー値を監視し、「なぜ止めたのか」を現場に説明する必要があるなら、まずT²法から試すのが実務的です。
振動の波形や画像を扱うならオートエンコーダ、項目が多くデータも大量ならIsolation Forestが候補です。正常データのまとまりが単純な形にならない場合は、その形に沿って境界を引けるOne-Class SVMも選択肢になります。
教師あり学習:不良品データが十分にある場合
不良品データが十分にあるかは、件数だけでなく、見分けたい不良の種類ごとに発生の記録と写真やセンサーデータがそろい、どれが何の不良かを後から確かめられるかで判断します。そろっていれば教師あり学習が使え、正解の札を手がかりに境目を直接学ぶため、学習した種類の不良は高い精度で見分けられます。札を不良の種類ごとに分けておけば「どの不良か」まで判定でき、種類に応じた対処にすぐつなげられます。
一方で、学習していない種類の不良は検出できる保証がなく、見逃しやすくなります。AIは見せられた札のどれかに当てはめて判定するため、初めて出た不良が「正常」に振り分けられれば、そのまま流出するおそれがあるからです。大量のデータに人が一つずつ札を付ける手間も、見落とされがちな負担です。
画像・映像を使った異常検知
外観検査では不良の画像が集まりにくいため、良品の画像だけを学習させ、良品の見た目の範囲から外れた部分を傷や汚れ、欠けとして拾う方法が広く使われています。多くの手法は画像を細かな部分ごとに良品と比べるため、どこが違うのかを色の濃淡で示せ、検査員は見るべき場所をすぐに確かめられます。
注意したいのは、撮影条件の変化に弱い点です。AIは学習したときの照明の当たり方やカメラの角度まで含めて「良品の見た目」として覚えるため、照明が少し変わっただけで、良品まで「いつもと違う」と判定されやすくなります。導入時は、検査治具で製品の位置と向きをそろえ、照明を固定するところまで設計します。
異常検知AIのメリットと国内メーカーの導入事例
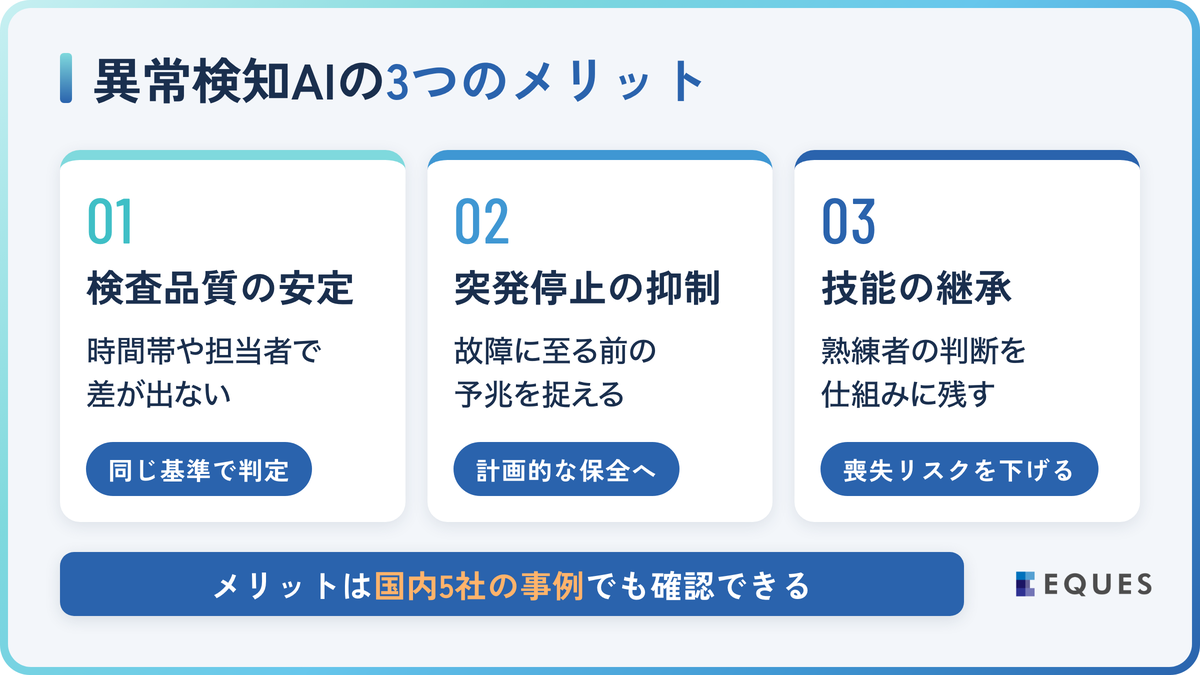
異常検知AIを導入すると、主に3つの点が良くなります。それぞれの理由を説明し、国内メーカー5社の公表事例で確かめます。
1. 検査品質の安定
目視検査は、検査員の熟練度や疲労で判定がばらつきます。異常検知AIは、同じモデルと同じ異常度の線ですべての製品を判定するため、時間帯や担当者による差が出にくくなります。見た目の良否のように基準を言葉にしにくい工程ほど効果が大きいのは、人が条件として書き出せない部分を、良品のデータから学んで補えるからです。
2. 突発停止の抑制
設備の劣化は、故障の前に振動や電流値のわずかな変化として表れることがあります。最初の章のモーターの例のように、しきい値に届く前の変化を異常度の上昇として捉えれば、故障で止まる前に点検できます。部品の手配や停止の時期を生産計画に合わせて前もって決められるため、突発停止を計画的な保全に置き換えられます。
3. 技能の継承
熟練者は、長年見てきた「いつもの状態」と比べて異変に気づきます。異常検知AIも正常なときのデータから「いつもの状態」を覚えるため、異変に気づく役目の一部をAIが受け持てます。ただし、熟練者の判断そのものを残すには、熟練者が下した良否の記録が要ります。その記録を教師あり学習の材料にしていけば、退職による技能の喪失リスクを下げられます。
国内5社の公表事例は次のとおりです。
| 企業 | 対象 | 方式 | 公表されている効果 |
|---|---|---|---|
| JFEスチール | 製鉄所の生産設備の異常予兆監視 | 正常時からの外れ度合いを指標化する「J-dscom」 | 最初に導入した熱延工場で年間50時間以上(生産量3万t以上)相当のトラブル抑止 |
| 東芝ライテック | 車載用LED製造ラインの外観検査 | 良品学習方式のAI画像検査を既存の検査装置と併用 | 検出精度の目標値95%を達成、目視作業の工数を約3分の1に削減 |
| ダイキン工業・JDSC | 市場に出た空調機器の不具合監視 | 過去の不具合データを学習したAI | 従来より1年以上早く不具合をフィードバック(試験運用で確認) |
| 武蔵精密工業・ABEJA | 自動車部品(ベベルギヤ)の検品 | 良品データのみから不良を判定する画像解析 | 約4か月の実証実験で目視と同程度の精度のモデルを構築 |
| キユーピー | 惣菜原料(カット野菜)の検査 | 良品のパターンを学習し、「良品以外」をすべて不良として検出する自社開発の検査装置 | 精度の向上と作業効率の向上を挙げる(数値の記載なし) |
表の5社を手法の違いで分けて読むと、自社に近い例と、3つのメリットとの対応が見えてきます。突発停止の抑制に当たるのは、電流・圧力・流量・温度・振動などのデータから、正常時の基準値に対する外れ度合いを異常度として指標化するJFEスチールの「J-dscom」です。効果を停止時間と生産量で示しているため、止まらなかった時間に時間あたりの生産額を掛ければ、投資対効果を金額で説明できます。
検査品質の安定に当たるのは、外観検査の3社です。東芝ライテックでは、ルールベースの検査装置について、どこまでチェックする範囲を広げればよいかに正解がなく、未知の不良の流出を防ぐ仕組みにもなっていなかったと説明されています。そこで装置を置き換えず、良品学習方式のAIを組み合わせ、今回のケースでは初期費用を約2分の1に抑えたとしています。
武蔵精密工業とABEJAの実証実験、キユーピーの検査装置も、良品のデータだけで不良を見分ける方式で、不良品データが少なくても始められることを示しています。なお、技能の継承を効果として挙げた事例は、今回の5社の公表内容には見当たりません。
ダイキン工業とJDSCは、3つのメリットとは別の、市場に出た製品の不具合を早く見つける使い方です。過去の不具合とそれに伴う製品対応のデータを学習させており、不具合の記録が積み上がる領域では、不具合側のデータを学ぶ方式も選べることを示しています。
参照元:JFEスチール(2021年9月)/東芝デジタルソリューションズ・導入事例(2025年3月取材)/ダイキン工業(2022年3月)/武蔵精密工業(2018年2月)/キユーピー(2019年2月)
異常検知AIが現場に定着しない3つの理由
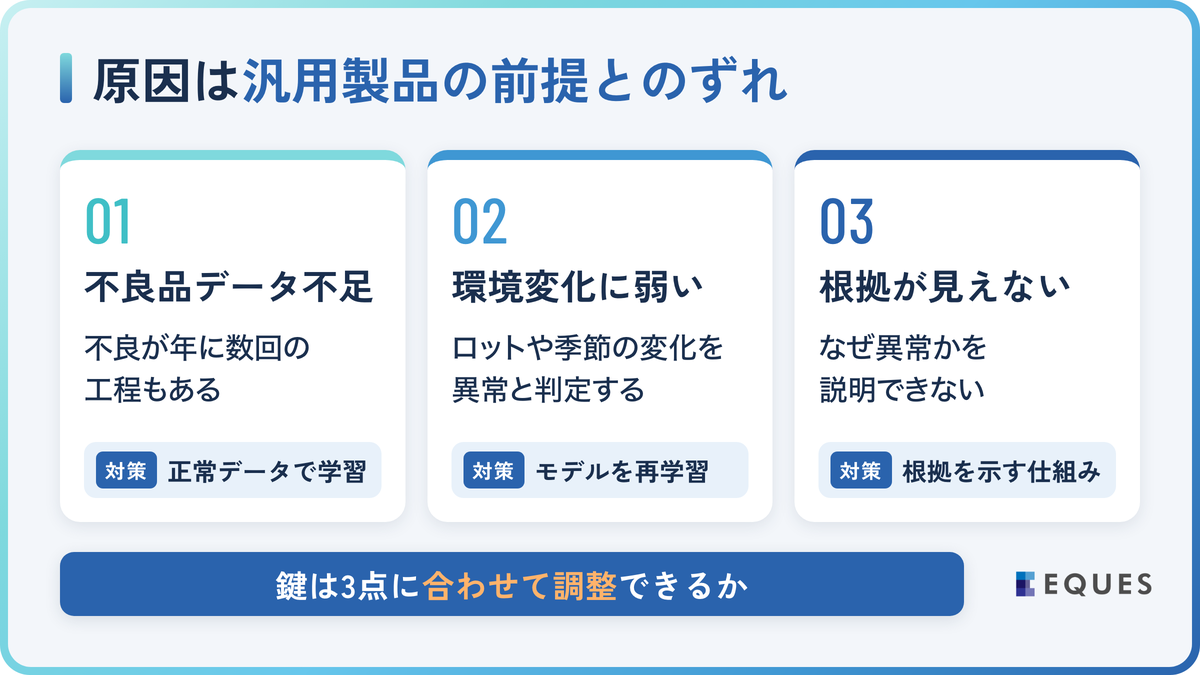
異常検知AIを導入しても、現場に定着しない例もあります。既製のパッケージでは、製品の品質より、汎用製品が想定する使い方と、現場の実情が合わないことが原因として考えられます。同じことは個別に開発したモデルでも起こりえます。合わなくなりやすいのは次の3点です。
1. 不良品データの不足
異常データでの学習を前提とする製品は教師あり学習で、不良の例から境目を覚えるため、歩留まりが高く不良が年に数回しか出ない工程では精度が出にくくなります。データ不足のまま導入すると見逃しや誤検知が多発するため、選定の段階で、正常データだけで学習できる方式かを確かめます。
2. 現場の環境変化への弱さ
原材料のロットや季節による温度・湿度の変化を、汎用製品は「異常」と判定しがちです。例えば、春に集めた正常データだけで学習したモデルを夏に使うと、気温の上昇で設備の温度や振動が少し変わっただけで「学習した正常の範囲の外」と見なされ、警報が増えます。誤検知が続けば現場はアラートを無視し、システムは形骸化します。
対策は、季節やロットの変動を含む期間の正常データで学習することと、気温やロットを入力の項目に加え、「この気温ならこのくらい」という関係ごと覚えさせることです。そのうえで、条件が変わったらモデルを再学習する体制を持ちます。パッケージを選ぶ際は、条件の変化に合わせて再学習できる仕組みかを確かめます。
3. 判断根拠が見えない
AIが「異常度が高い」とだけ示し、なぜ異常かを説明できなければ、ラインの担当者は設備を止めるべきか判断できず、品質保証の担当者も不合格の理由を記録に書けません。これでは現場の信頼を得られず、品質記録を残す工程では採用の障害にもなります。精度の数値だけでなく、どのセンサーが異常度を押し上げたのか、画像のどこが違うのかといった判定の根拠を示せる仕組みかを確かめます。
一方で、前章の東芝ライテックのように、既製のパッケージで成果を出せる現場もあります。検査対象が規格化され、撮影条件が安定した工程なら、既製品のほうが短期間で導入できます。成否を分けるのは、製品か個別開発かではなく、データ量・環境変化・説明責任の3点に合わせて調整できるかです。
失敗しない異常検知AIプロジェクトの進め方
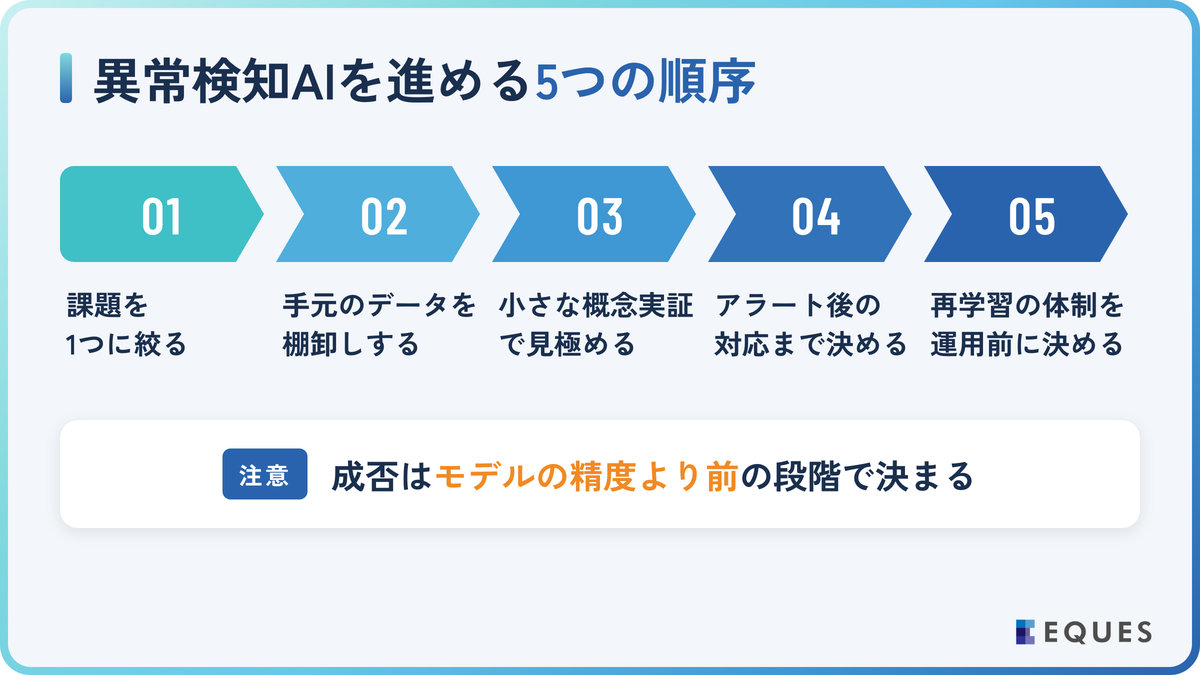
異常検知AIの成否は、モデルの精度より前の段階で決まります。概念実証(PoC)で「異常の8割を検出できた」という結果が出ても、見逃してはいけない異常や、1日に受け止められる誤検知の回数を決めていなければ、それで十分かを誰も判断できないからです。
NEDOの「スマートマニュファクチャリング構築ガイドライン(第2版)」(2025年5月)も、経営や業務の変革課題を特定するところを起点に、導入前の企画・構想設計に重点を置いています(参照元:NEDO)。
- 解決したい課題を1つに絞る:「品質を上げたい」ではなく、「Aラインの外観検査で傷の見逃しを減らす」「このポンプの突発停止を計画停止に置き換える」まで具体化します。対象が決まれば、見るべきデータも評価の物差しも決まります
- 手元のデータを棚卸しする:どのセンサーの値が、どの間隔で、どの期間分残っているかを確認します。1分ごとの平均値だけでは振動の波形は追えず、季節をまたぐ期間がなければ季節の変動を学べません。保全記録で故障の日時がわかれば、故障の前に劣化が進んでいた期間を学習用の正常データから外せます。混ざったままだと、AIは劣化した状態まで「いつもの状態」として覚えてしまうからです。不足していれば、記録の仕組みづくりから始めます
- 小規模な概念実証(PoC)で見極める:1つの設備・1つの検査項目に絞り、検出できる異常と誤検知の頻度を実測します。保全記録にある過去の故障の前に、異常度が上がっていたかも確かめます。異常度の線を低くすれば見逃しは減る代わりに誤検知が増え、高くすればその逆になるため、どちらをどこまで許容するかを先に決めておきます
- 現場の運用に組み込む:アラートが出たら、誰が、いつまでに、何を確かめ、結果をどう記録するかまで決めます。決めていないと、検知しても活用されません
- 継続的に再学習する:原材料の変更や季節、設備の更新など、モデルを更新するきっかけと担当者を、運用開始前に決めておきます。決めないと、誤検知が増えてもモデルが放置されます
概念実証の手順は「PoCの進め方|5つのステップとチェックリスト・成功事例4選」で解説しています。
異常検知AIは、値が記録として残っていなければ学習も判定もできません。その記録づくりの例として、細胞・遺伝子治療の製造を受託するCyto-Factoでは、通信機能のない機器の液晶パネルの表示を、作業員が手作業で記録していました。弊社は、この表示をAI-OCR(AIによる文字読み取り)で読み取って記録する仕組みの開発を支援しています。

参照元:株式会社EQUES「AI-OCRで製造現場の記録を自動化|Cyto-Factoの導入事例」(2025年10月)
異常検知の事例ではありませんが、概念実証で、できることと足りないものを先に確かめた例もあります。SOLIZE PARTNERSとの取り組みでは、弊社の概念実証サービス「ココロミ」で、熟練技術者の設計ノウハウをAIに組み込めるかを見極めました。単純な形状なら3D CADデータを自動生成できる一方、複雑な形状にはデータの事前整備が要るとわかりました。
参照元:株式会社EQUES「SOLIZE PARTNERSが語る、製造業のDXにおけるAI活用のはじめの一歩」(2025年10月)
異常検知AIに関するよくある質問
異常検知AIは「いまの状態がいつもと違うか」を知らせる技術で、予知保全は、設備の状態から故障の時期を見込んで保全の時期を決める考え方です。異常検知は予知保全の入り口にあたり、劣化の進み方のデータが蓄積されると、故障までの残り時間を見積もる段階に進めます。
生成AIに産業用の画像を見せて異常を判定させた評価(ICLR 2025)では、当時最良のGPT-4oでも検査の設問の平均正答率は74.9%で、著者らは産業の要求水準に遠く及ばないとしています。現時点では、検知は本記事で紹介した手法で行い、生成AIは検知結果を文章で説明する用途から試すのが安全です。
まずは、PLCやデータロガーにすでに残っている電流・温度・圧力などのデータから試せます。ただし、見つけたい故障の兆しが手元のデータに表れるとは限りません。例えば、軸受の傷みは振動に表れやすいため、振動を測っていない設備ではセンサーの追加を検討します。
対象範囲とデータの整備状況で変わります。データがそろっていれば、概念実証は数か月規模で実施できます。記録の仕組みから作る場合は、その準備期間が加わります。
参照元:Jiangほか「MMAD」(ICLR 2025)
まとめ:異常検知AIは手法よりデータの状況から選ぶ
異常検知AIは、データの中から「いつもと違う」ものを見つける仕組みで、代表的なのは正常なときのデータだけで「いつもの状態」を学び、外れ具合を異常度として示す方式です。成否を分けるのは手法の種類より、手元のデータの見極めです。
- 手法は不良品データの量で選び、データが少ないうちは正常データだけで学ぶ教師なし学習から始めます
- 現場に定着させるには、既製品か個別開発かを問わず、データ不足・環境の変化・判定の根拠の3点に合わせて調整できるかを確かめます
- 課題の絞り込み、見逃しと誤検知の許容範囲、アラート後の対応、再学習の体制を、導入前に決めておきます
異常検知AIの検討でお悩みの際は、お問い合わせよりお気軽にご相談ください。最後までお読みいただき、ありがとうございました。
異常検知AIを自社データで試しませんか
AI PoCサービス「ココロミ」が、現状分析から検証・評価、アクションプランの策定まで伴走します。まずは無料相談からどうぞ。