記事の要約
- ローカルLLMでのRAG構築とは、文書を検索して根拠に答えさせる仕組み(RAG)を、文書もモデルも自社環境に置いたまま組み上げることです。
- 構築は文書の前処理、チャンク(=検索単位の断片)への分割、埋め込み(=文章の数値化)とベクトルDB(=数値化した文章の保存先)への登録、検索と生成、評価の5ステップで進めます。
- 安全面では、閲覧権限を検索の段階で反映し、文書に紛れた命令への対策とログの記録を重ねます。総務省のガイドラインも組織内の利用者による攻撃を想定しています。
「社内規程やマニュアルを生成AIで検索したいが、文書をクラウドには送れない」。こうした制約から、情シスや開発の現場でローカルLLM(=自社のPCやサーバーで動かす大規模言語モデル)によるRAGの構築が検討されます。
本記事では、ローカルLLMでRAGを構築する手順を、部品の選び方、5つの構築ステップ、セキュリティ設計の順に解説します。
東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社が、検証の現場で重視する点も添えます。
目次
ローカルLLMでRAGを構築するとは?仕組みとクラウド型との違い
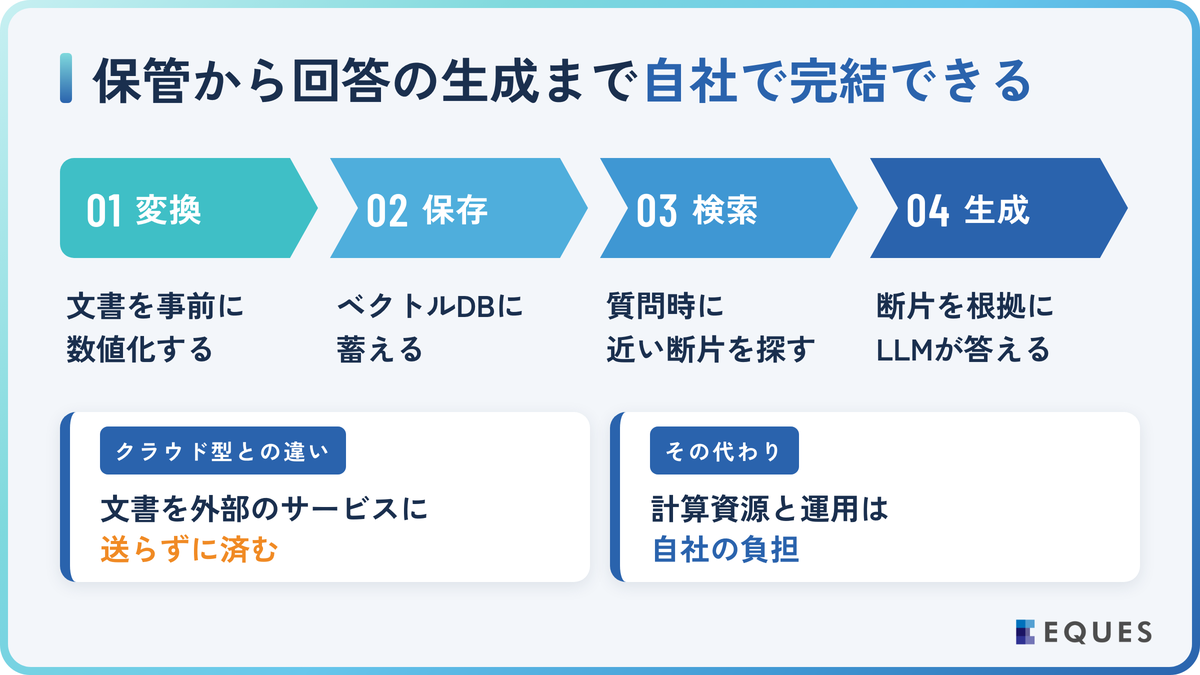
RAG(検索拡張生成。=文書を検索し、その内容を根拠に答えさせる仕組み)は、モデルを学習し直さずに社内の知識を扱えるのが利点です。
文書は事前に埋め込み(=文章の意味を数値の並びに変換する処理)で数値化し、ベクトルDB(=数値化した文章を保存し、近いものを探すデータベース)に蓄えます。
埋め込みは、意味の近い文を近い数値に写す処理です。質問も同じ写し方で数値にするため、言い回しが違っても同じ内容の断片が近くに並び、LLMはそれを根拠に答えます。
逆に、索引に無い文書は出てこず、粗く切った断片は関係ない部分ごと拾われて精度を下げます。精度が出ないときは、どの断片が拾われたかを見ると原因が絞れます。
ローカルLLMで構築すると、文書の保管から回答の生成までを自社のサーバーや閉域網(=インターネットから切り離した専用の通信網)で完結できます。文書を外部のサービスに送らずに済む点が、クラウド型との大きな違いです。
その代わり、計算資源と運用は自社の負担です。推論(=学習済みモデルで回答を生成する処理)に要るVRAM(=GPUに載ったメモリ)の目安は「ローカルLLMとは?仕組みとメリット・必要なPCスペック2026」で解説しています。
自治体では、山口県とNTT西日本が、機微なデータを扱うためにオンプレミス(=自前の施設内に機器を置いて運用する形態)の小型GPUサーバーでLLM「tsuzumi」を動かし、業務マニュアルの検索・要約などを想定した実証を2024年9月に発表しました。
参照元:NTT西日本・山口県「機微データを扱う業務への大規模言語モデルtsuzumi活用に関する実証実験を開始」(2024年9月17日)
ローカルRAGを構成する5つの部品と代表ツール【比較表】
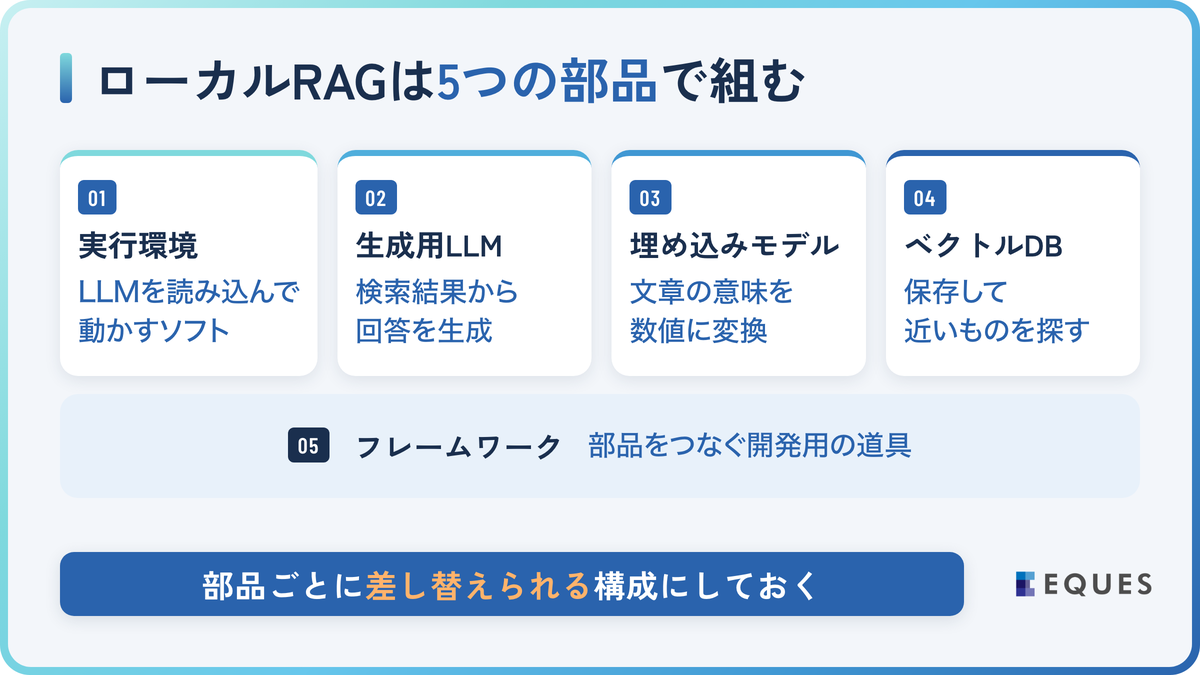
ローカルRAGは、実行環境(=LLMを読み込んで動かすソフト)・生成用LLM・埋め込みモデル・ベクトルDB・フレームワーク(=部品をつなぐ開発用の道具)の5つの部品で組みます。部品ごとに差し替えられる構成にしておくと、評価に応じて入れ替えられます。
| 部品 | 代表例 | 選ぶ観点 | 注意点 |
|---|---|---|---|
| 実行環境 | Ollama、llama.cpp、vLLM | 試作か、複数人での利用か | 規模に応じて移行 |
| 生成用LLM | Qwen3.8、gpt-oss、Gemma 4など | 日本語の品質、VRAMに収まるか | 商用条件がモデルごとに違う |
| 埋め込みモデル | multilingual-e5-large、BGE-M3、Ruri v3 | 日本語の検索精度、入力の上限 | 索引と質問で同じモデルを使う |
| ベクトルDB | Chroma、Qdrant、Milvus、pgvector | 規模、絞り込み、権限管理 | 初期設定の認証の有無 |
| フレームワーク | LangChain、LlamaIndex | 部品の接続、文書の読み込み | 版を固定して検証 |
生成用LLMの商用利用の条件は「ローカルLLMの商用利用|ライセンスの見方と8モデル比較2026」で比較しています。
実行環境は「1台で試すか、複数人で使うか」で選ぶ
実行環境は、利用の規模で選びます。1台で試すならOllamaかllama.cpp、複数人ならvLLMが主な候補です。
Ollamaはモデルの取得と実行をコマンドで扱え、埋め込みの生成にも対応します。llama.cppはC/C++(=処理の速さに優れるプログラミング言語)製で、1.5〜8ビットの量子化(=数値の精度を落としてモデルを軽くする処理)に対応します。
vLLMは多数の問い合わせを効率よくさばくサーバー運用向けのライブラリ(=プログラムに組み込んで使う部品集)で、OpenAI互換のAPI(=OpenAIと同じ形式で呼べる窓口)を備えます。
埋め込みモデルとベクトルDBは日本語と権限管理で選ぶ
埋め込みモデルは、日本語の検索精度を大きく左右します。日本語の学習が薄いモデルでは、同じ意味の日本語文が離れた数値に写され、検索で拾えないためです。入力の上限と接頭辞の指定は、公開元の説明書きであるモデルカードで確認します。
multilingual-e5-largeは512トークン(=モデルが文章を数える単位)を超える入力を切り捨て、文頭に「query: 」「passage: 」を付ける指定があります。接頭辞を省くと性能が落ちると注記されています。
上限を超えた部分は索引に入らず、長い条文の後半だけの例外は「規程にあるのに出てこない」形で現れます。
名古屋大学の研究者が公開したRuri v3は日本語特化で、8,192トークンまで扱えます。BGE-M3は100以上の言語に対応し、意味の近さと語の一致の両方を1つのモデルで扱えます。
ベクトルDBは、試作なら手軽なChroma、絞り込みや権限管理を重視するならQdrantかMilvus、既存のPostgreSQLに載せるならpgvectorが候補です。
参照元:Ollama「Embeddings」、ggml-org「llama.cpp」、vLLM「vLLM」、intfloat「multilingual-e5-large」、BAAI「BGE-M3」、cl-nagoya「ruri-v3-310m」、名古屋大学「Ruri論文」、Chroma「Chroma」、Milvus「Milvus」、pgvector「pgvector」(2026年10月12日確認)
ローカルLLMでRAGを構築する5ステップ
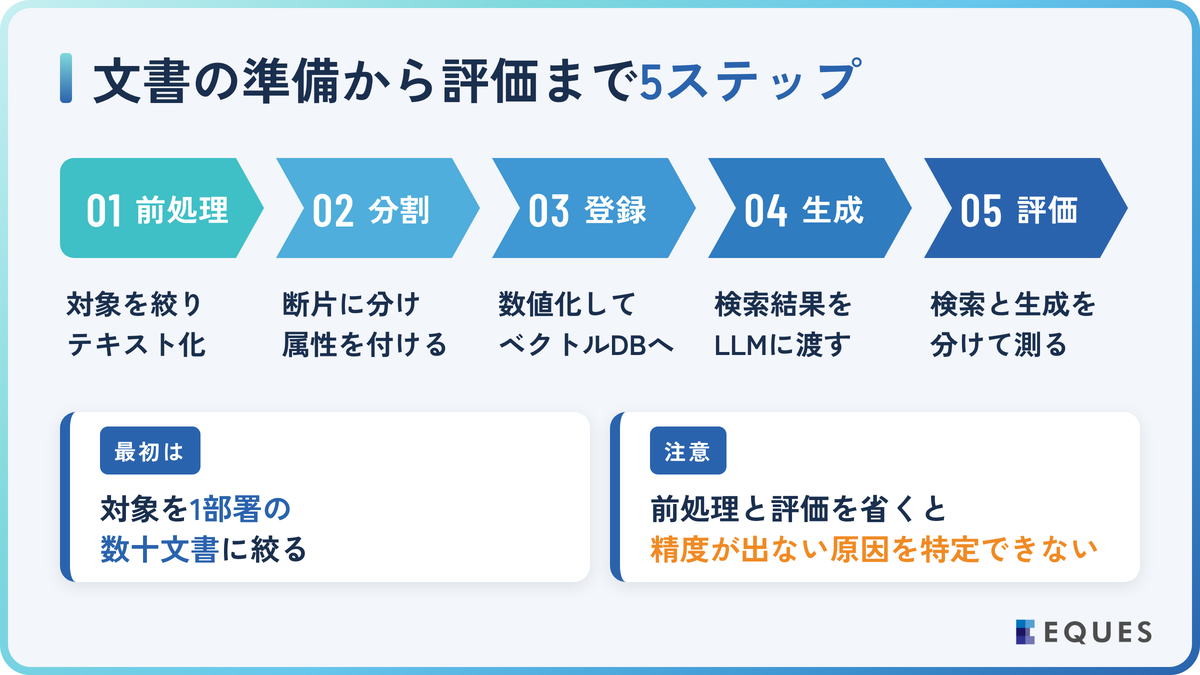
構築は、文書の準備から評価までの次の5ステップで進めます。最初は対象を1部署の数十文書に絞り、評価で手応えを確かめてから範囲を広げると、手戻りを抑えられます。とくに入口の前処理と出口の評価を省くと、精度が出ない原因を特定できません。
1. 対象文書を絞り、テキストに変換する
検索させたい文書の種類と範囲を決め、PDFやWordのファイルをテキストに変換します。表や段組みが崩れたまま取り込むと、後の工程で取り戻すのは難しくなります。
変換後のテキストを人が開き、表の行と列の対応や、ヘッダー・フッターの混入を確かめます。改廃の多い規程類は、版数と施行日を控えておくと後の更新管理に使えます。
2. 文書をチャンクに分割し、属性を付ける
チャンクは、見出しや条番号など意味の切れ目で区切ります。埋め込みモデルの入力上限より短く切るのが前提で、上限を超えた部分を切り捨てるモデルもあります。
文字数だけで機械的に切ると、条文の原則と例外が別の断片に分かれ、例外だけが拾われて逆の回答が返ることがあります。
各チャンクには、文書名・部署・機密区分・版数などのメタデータ(=絞り込みに使う付帯情報)を付けます。この属性が、閲覧権限を検索結果に反映する土台になります。
3. 埋め込みを作り、ベクトルDBに登録する
チャンクを埋め込みモデルで数値化し、メタデータと一緒にベクトルDBへ登録します。索引の作成と質問の数値化には同じモデルを使います(Ollama公式ドキュメント)。モデルが違えば数値への写し方も違い、同じ文が別の位置に置かれて近さの比較が成り立たないためです。
埋め込みモデルを後から替えると、全文書の数値化をやり直すことになります。文書が増える前に、候補のモデルを自社の文書で比べておくと作り直しを防げます。
4. 検索結果をLLMに渡して回答を生成する
質問を同じモデルで数値化し、近いチャンクを上位から数件取り出してLLMに渡します。渡した文書の範囲で答え、根拠の文書名を示すよう、システムプロンプト(=LLMに事前に与える指示文)で指定します。
埋め込みは意味の近さで探すため、型番の一字違いを軽く見て、似た型番の別製品が返ることがあります。型番や条番号など文字列の一致が手がかりになる質問には、キーワード検索を併用します。処理の連結にはLangChainやLlamaIndexが使えます。
5. 想定質問で検索と回答を評価する
現場の担当者から実際の質問と正解の文書を集め、評価用の質問集を作ります。正解の文書が検索の上位に入ったかと、回答が文書に忠実かを分けて記録すると、直す場所が分かります。
精度が届かないときは、原因が検索と生成のどちらにあるかを先に切り分けます。検索で正解が落ちていれば、生成の指示を直しても答えは良くならないためです。直し方は「RAG導入で精度が出ない3つの原因と改善手順【2026年版】」で解説しています。
参照元:LangChain「LangChain」、LlamaIndex「LlamaIndex」
社内文書検索を安全にするローカルRAGのセキュリティ設計
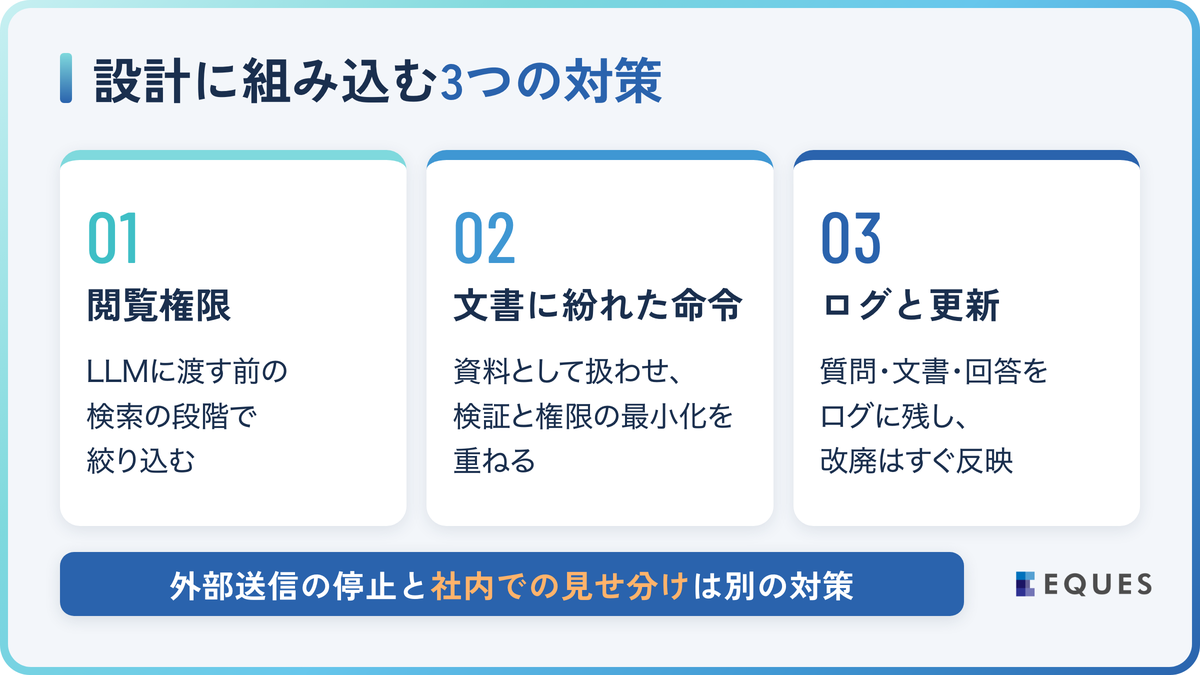
ローカル構成でも、社内の利用者が権限外の文書を引き出す経路は残ります。外部送信を止めることと、社内での見せ分けは別の対策です。
総務省の技術的対策ガイドライン(2026年3月)も、RAGを使う社内向けチャットボットを想定事例に挙げ、組織内の利用者による攻撃を想定しています。次の3点を設計に組み込みます。
1. 閲覧権限を検索の段階で反映する
権限は、LLMに渡す前の検索の段階で絞り込みます。チャンクに付けた部署や機密区分を利用者の所属と照らし、閲覧できない文書を検索結果から除きます。
LLMへの「見せないで」という指示だけでは、巧妙な質問で破られるおそれがあります。
ベクトルDB自体の認証も確かめます。Qdrantは、最小構成の起動では認証がかからないと注意を促しています。
2. プロンプトインジェクションに備える
プロンプトインジェクション(=文書や入力に紛れた命令でAIを誤動作させる攻撃)は、RAGでは取り込んだ文書からも入り込みます。検索対象の文書が攻撃の入口になる点がRAG特有のリスクです。
対策は、参照文書を指示ではなく資料として扱わせる指示文、入力・参照文書・出力の検証、LLMに与える権限の最小化を重ねることです。セキュリティの非営利団体OWASPも、確実な防止策があるかは不明として多層の対策を勧めています。
3. ログとモデル・文書の更新を管理する
質問・検索された文書・回答をログに残します。ログは原因究明と監査の証拠になるため、保存期間と閲覧できる人の範囲も決めておきます。
文書の改廃はインデックス(=検索用の索引データ)にすぐ反映し、廃止した版が回答に出ないようにします。モデルを更新したときは、質問集で測り直してから切り替えます。
参照元:総務省「AIのセキュリティ確保のための技術的対策に係るガイドライン」(2026年3月)、OWASP「LLM01:2025 Prompt Injection」(Top 10 for LLM Applications 2025・2024年11月)、Qdrant「Qdrant」
このように、ローカルRAGは部品選びと権限設計を同時に進める必要があります。こうした検討に対し、弊社は東大出身のAI専門家にチャットで相談できる「AI×DX寺子屋」(プランA=月額20万円・税抜で相談し放題)を提供しています。
本番開発の前に自社データで小さく検証する段階では、AI PoCサービス「ココロミ」(スリムプラン月々99万円〜・スタンダードプラン月々250万円〜)でご一緒できます。
例えばSOLIZE PARTNERS株式会社とのPoCでは、形状データから設計の知見を提案するAIを検証し、過去資料や文献を検索する手間をかけずに設計のヒントを得られるようになりました。
参照元:株式会社EQUES「SOLIZE PARTNERS株式会社 導入事例」
ローカルLLMのRAG構築に関するよくある質問
小さなモデルなら試せます。llama.cppはCPUだけでも動作し、量子化でメモリ使用量を抑えられます。ただし応答は遅く、複数人で使う本番はGPUを前提に見積もります。
文書の更新が多く根拠を示したいならRAG、専門知識を覚えさせたいならファインチューニング(=自社データでモデルを追加学習すること)が向きます。
中国電力とNTTドコモビジネスは、RAGなどでは実務に十分な精度が出ない場合があったとして、「tsuzumi 2」に業務データを学習させる検証を始めました(2026年1月発表)。方法は「ローカルLLMでファインチューニングを行う方法とは?手順や必要な環境を解説」をご覧ください。
自社の文書と想定質問で比べて選びます。日本語中心ならRuri v3などの日本語特化、英語の資料も混ざるならBGE-M3などの多言語が候補です。
外部送信は抑えられますが、権限外の文書の表示や文書に紛れた命令による誤回答は残ります。モデルの取得元の信頼性も確かめます。
まとめ
ローカルLLMでのRAG構築は、部品を差し替えられる形で組み、評価と権限設計を最初から入れることが近道です。
- 日本語では、埋め込みモデルの選択と入力上限・接頭辞の確認が検索精度を左右する
- 前処理、分割、埋め込みと登録、検索と生成、評価の5ステップで進め、検索と生成を分けて測る
- 閲覧権限は検索の段階で反映し、プロンプトインジェクション対策とログ・更新の管理を重ねる
ローカルLLMでのRAG構築の進め方に迷われている段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
ローカルRAGの設計をチャットで相談しませんか
AI×DX寺子屋では、部品選びや権限設計の疑問を東大出身のAI専門家にチャットで相談できます。まずは無料相談からどうぞ。