記事の要約
- AIアノテーションとは、画像やテキストなどのデータに正解となる情報を付与し、AIが学習できる教師データを作る作業のことです。
- 作業の品質は担当者の熟練度よりも、判断基準を定めた基準書の整備と、判断の一致率を測る仕組みに大きく左右されます。
- 効率化にはツールの導入、外部委託、AIによる下書きの3つの方向があり、対象の件数と判定に必要な専門性によって適した選択肢が変わります。
AI開発のプロジェクトで、モデルの精度がどうしても上がらない。パラメータを調整しても改善せず、原因が分からないまま時間が過ぎていく。
こうした行き詰まりの背景には、学習に使っている教師データそのものの品質問題が潜んでいることが少なくありません。AIアノテーションは地味な工程ですが、ここでの判断のぶれがそのままモデルの精度の上限を決めてしまいます。
本記事では、AIアノテーションの基本と種類、実施手順を整理したうえで、実際の現場で品質を落とす典型的な失敗と、その防止策を具体的に解説します。
さらに、ツール・代行サービス・AIによる自動化という効率化の選択肢を比較し、自社に合う手段の選び方まで示します。読み終えるころには、自社のデータ準備のどこに手を入れるべきかが判断できるようになります。
目次
AIアノテーションとは?なぜモデルの精度を左右するのか
AIアノテーションとは、画像・動画・音声・テキストといったデータに対して、AIが学習するための正解情報を付与する作業を指します。
たとえば製造ラインの写真に対して「この範囲が傷である」と囲んで示したり、問い合わせのメール文に「これはクレームである」と分類を与えたりする作業です。こうして作られたデータを教師データと呼び、AIはこれを手本としてパターンを学びます。
この工程が精度を左右する理由は単純です。AIは与えられた正解を疑わず、そのとおりに学習するためです。人が付けたラベルに誤りやばらつきがあれば、AIはその誤りごと学習します。
同じ傷の写真に対して、ある担当者は傷と判定し、別の担当者は傷ではないと判定していれば、AIは何を傷と呼ぶべきか学べません。
モデルの構造や計算資源をどれだけ強化しても、教師データの一貫性を超える精度は出ないという関係にあります。精度が頭打ちになったとき、まず疑うべきはモデルではなくデータです。
AIアノテーションの主な種類
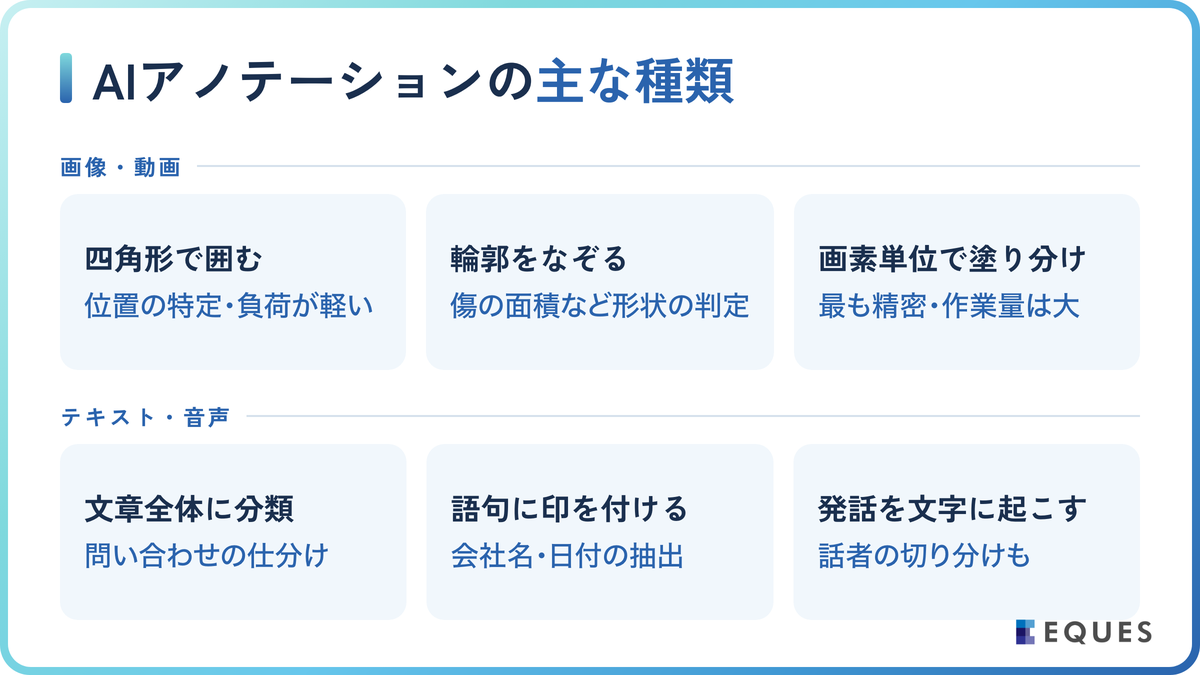
アノテーションの手法は、扱うデータの種類と、AIに解かせたい課題によって決まります。同じ画像データでも、対象の位置を知りたいのか、形状の細部まで必要なのかで付与すべき情報はまったく変わり、作業量も数倍の差が出ます。
そのため、手法を選ぶ前に課題の定義を固めておく必要があります。ここでは、画像・動画と、テキスト・音声に分けて代表的な手法を確認します。
画像・動画のアノテーション
最も広く使われているのが、対象物を四角形で囲む方法です。写真の中から製品や人物の位置を特定する用途に向いており、作業負荷が比較的軽い点が利点です。対象の輪郭を細かくなぞる方法もあり、こちらは形状そのものが判定に影響する場面、たとえば傷の面積を測る用途などで使われます。
画素単位でどの領域が何であるかを塗り分ける方法は、最も精密ですが作業量も大きくなります。このほか、関節や特徴点の位置を指定する方法は、人の姿勢や動きの解析に用いられます。
動画の場合は、フレームごとに同じ対象を追跡する必要があり、静止画に比べて作業量が大きく膨らむ点に注意が必要です。
どの手法を選ぶかは精度要求と予算のバランスで決まりますが、迷ったときは「AIに何を答えさせたいか」に立ち返ると判断できます。
テキスト・音声のアノテーション
テキストでは、文章全体に分類を与える方法と、文中の特定の語句に印を付ける方法が中心です。前者は問い合わせ内容の仕分けや評判の判定に、後者は文書から会社名・日付・金額といった情報を抜き出す用途に使われます。
業務文書を扱う場合、業界特有の用語や略称の扱いを決めておかないと、担当者ごとに判断が分かれます。
音声では、発話内容を文字に起こす作業に加え、話者の切り分けや、音の種類の分類といった作業があります。テキストと音声に共通するのは、正解が一意に決まらない場面が画像より多いという点です。だからこそ、次章で述べる基準書の整備が重要になります。
AIアノテーションの手順7ステップ
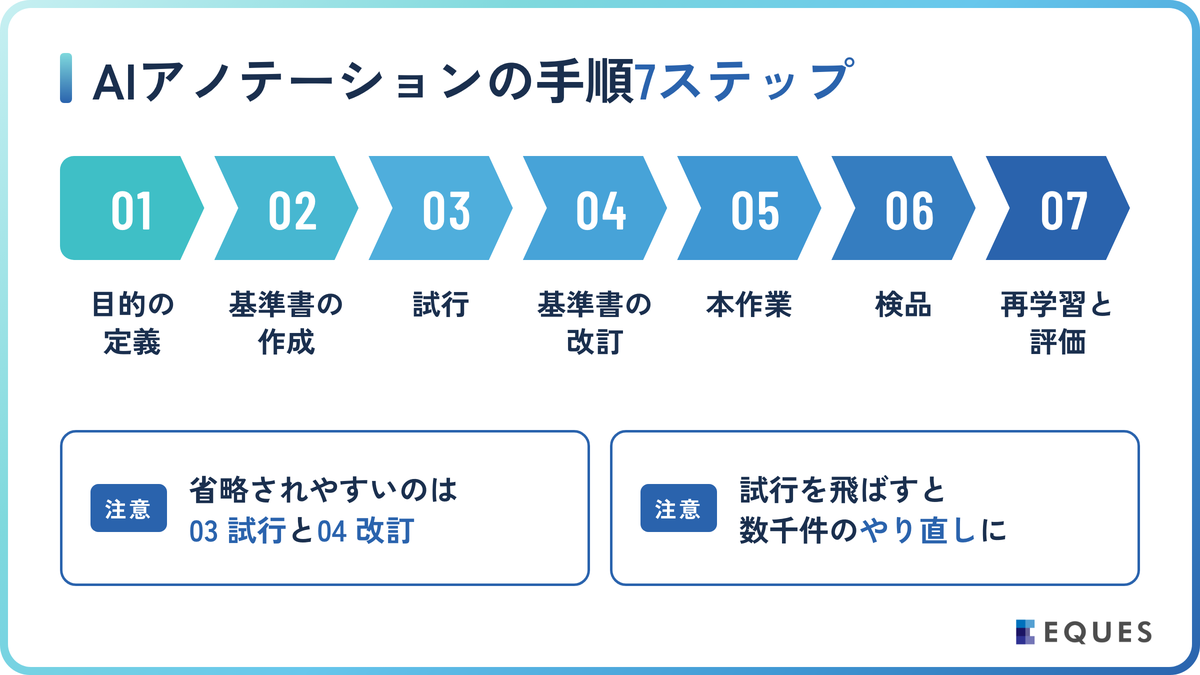
実務での進め方は、次の7段階に整理できます。最初の2段階に時間をかけることが、結果的に全体の工数を減らします。
- 目的の定義:AIに何を判定させるかを一文で言語化する
- 基準書の作成:判断に迷う事例と、その場合の扱いを明記する
- 試行:少量のデータで複数人が作業し、判断のずれを確認する
- 基準書の改訂:ずれた箇所について、判断基準を追記する
- 本作業:確定した基準に沿って作業を進める
- 検品:抽出または全件で確認し、誤りを修正する
- 再学習と評価:モデルの精度を確認し、必要に応じて基準を見直す
この手順で最も省略されやすいのが3番目の試行と4番目の改訂です。基準書を書いた時点では完璧に見えても、実際のデータにはほぼ必ず例外が現れます。少量で試して判断がずれた箇所こそ、基準書に書くべき内容です。
試行を飛ばして本作業に入ると、数千件を終えた後でばらつきが判明し、やり直しになるという事態を招きます。
最後の7番目についても、一度で終わりと考えないでください。モデルの精度を確認して初めて、基準の定義が適切だったかが分かります。
品質を落とす3つの失敗と防止策
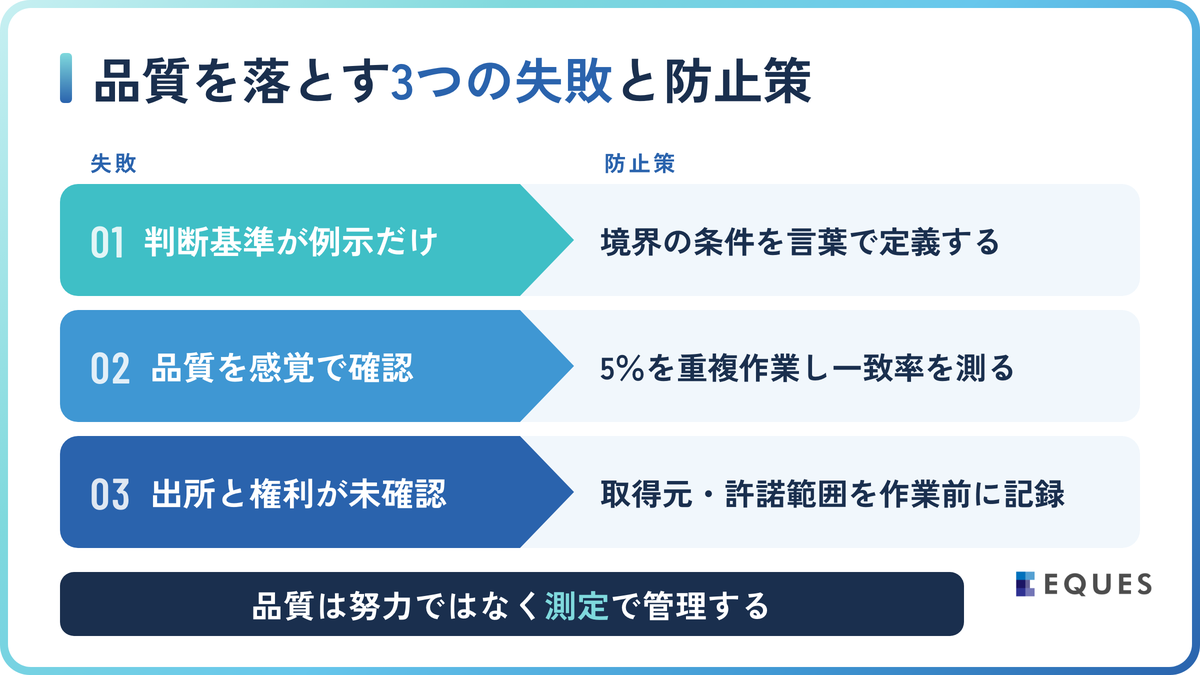
ここからが本題です。アノテーションの品質が崩れる原因は、担当者の能力不足ではなく仕組みの不備にあります。現場で繰り返し起きる失敗を3つ挙げ、それぞれの防止策を示します。
失敗1:判断基準が「例示」だけで書かれている
基準書に良い例と悪い例の写真だけが並び、判断の理由が書かれていないケースです。例示にない中間的なデータが出てきたとき、担当者は自分の解釈で判断せざるを得ず、ばらつきが生じます。
防止策は、境界の条件を言葉で定義することです。「長さ2ミリ以上のものを傷とする」「判断がつかない場合は保留ラベルを付け、後でまとめて協議する」といった形で、迷ったときの行動まで指定してください。保留という選択肢を用意しておくことが、無理な判断による汚染を防ぎます。
失敗2:品質を感覚で確認している
検品担当者が目視で確認し、「だいたい問題ない」と判断している状態です。これでは、どの程度のばらつきが残っているのかが分かりません。
防止策は、複数人が同じデータに作業し、判断がどれだけ一致したかを数値で確認することです。全体の一部、たとえば5%程度を重複して作業させ、一致率を測定します。一致率が低い項目は、担当者の問題ではなく基準の曖昧さを示しているため、基準書の改訂につなげます。
主観の入る判定では、3人以上で作業して多数決を取る方法も有効です。重要なのは、品質を人の努力ではなく測定で管理することです。
失敗3:データの出所と権利関係を確認していない
精度の問題とは別に、後から重大な支障となるのがこの点です。学習に使うデータが、著作権や個人情報の観点で適切に取得されたものかを確認しないまま作業を進めると、完成したモデルを商用利用できない事態が起こり得ます。
実際、デジタル庁が政府利用に向けて国内開発の大規模言語モデルを公募した際にも、学習用データに関する法令遵守の状況を具体的に説明できることが選定の基準とされました。公的な利用ではこの水準の確認が求められているということです。
防止策は、データの取得元・取得方法・利用許諾の範囲を、作業開始前に一覧として記録しておくことです。
参照元:デジタル庁「ガバメントAIで試用する国内大規模言語モデル(LLM)の公募結果」(2026年3月6日公表)/文化庁「AIと著作権について」
AIアノテーションを効率化する3つの選択肢
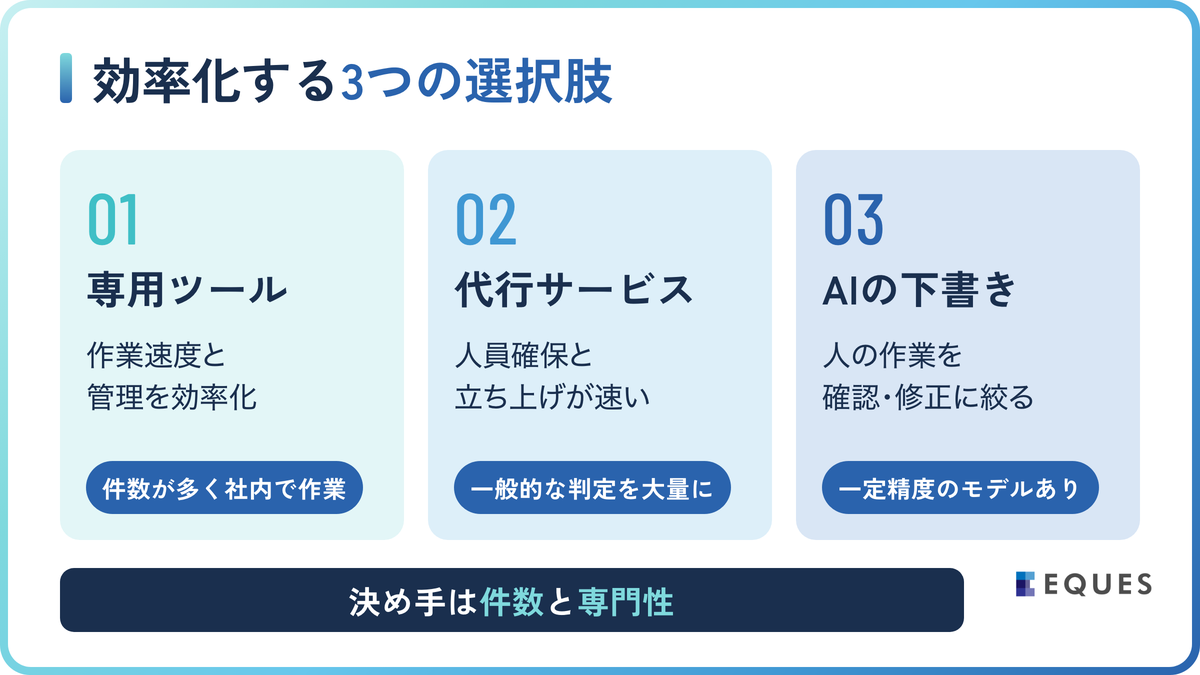
アノテーションは工数のかかる工程です。効率化の手段は大きく3つあり、それぞれ適した状況が異なります。
| 選択肢 | 主な効果 | 注意点 | 向いている状況 |
|---|---|---|---|
| 専用ツールの導入 | 作業速度と管理の効率化 | 基準の曖昧さは解消しない | 件数が多く社内で作業する |
| 代行サービスの活用 | 人員確保と立ち上げの速さ | 専門知識の共有に時間が必要 | 一般的な判定で件数が多い |
| AIによる下書き生成 | 人の作業を確認・修正に絞れる | 誤りの見逃しが起きやすい | ある程度の精度のモデルが既にある |
ツールを導入する場合は、まず無償で試せるオープンソースから当たりをつけるのが現実的です。代表的なツールを、提供形態と対応データの観点で整理します(特徴は各公式サイトの記述に基づきます。優劣を示すものではありません)。
| ツール名 | 提供形態 | 対応データ・特徴(公式サイトの記述より) |
|---|---|---|
| Label Studio | オープンソース(開発元:HumanSignal) | 画像・テキスト・音声・動画・時系列など幅広いデータ種別に対応。データラベリングとAI評価、人が介在するワークフローの基盤 |
| CVAT | オープンソース(自社構築版)+クラウド版 | 画像・動画・3D点群・音声に対応。矩形・追跡・3D空間での検出に強み。クラウド版には無料プランあり |
| Labelbox | 商用(エンタープライズ向け) | テキスト・マルチモーダル・動画などのデータ基盤。近年はAIの評価・強化学習向けデータや専門家による評価も提供 |
| SuperAnnotate | 商用 | 本番運用を前提としたAIデータ基盤を掲げるプラットフォーム |
| Roboflow | 商用(無料枠あり) | 開発者・企業向けのコンピュータビジョンツール群。アノテーションから学習・デプロイまでを扱う |
| FastLabel | 商用(国内) | 高品質で大規模なデータを、プロダクト(ツール)とプロフェッショナルサービス(代行)の両軸で提供 |
代行サービスは、人員確保と立ち上げの速さが利点です。国内では上記のFastLabelのほか、ヒューマンサイエンスがテキスト・音声・画像・動画に対応し、教師データ作成実績4,800万件以上、ツール・教育・環境の3つの軸によるセキュリティ体制を公式サイトで掲げています。
海外ではScale AIが大規模なAIモデル開発向けのデータ作成を手がけています。代行サービスを選ぶ際は、料金の比較だけでなく次の観点を確認してください。
自社の業界・データ種別での実績があるか、機密保持と作業環境のセキュリティが担保されているか、品質の測定方法と保証の範囲が契約に明記されているか、基準書の作成を支援してもらえるか、修正対応の範囲と回数が定められているか、作業者への教育体制があるか、そして納品データの権利の扱いが明確か。
とくに品質の測定方法は、契約前に必ず擦り合わせてください。
なお、専門性の高い判定は外部委託が難しい領域です。弊社がニッセンケン品質評価センターと共同で取り組んだ繊維種の判別では、見た目や成分が非常に類似し、従来の化学分析から人間が確実に識別することが困難な対象を扱いました。
ディープラーニングを適用した結果、多変量解析だけでは判別が難しかったサンプルのうち、最大で80%以上の精度での判別が可能になっています。
このように、専門家の知見をどうデータに落とし込むかが成否を分ける領域では、作業を切り出すのではなく、専門家と開発側が一緒に設計することが必要になります。
弊社は東京大学松尾研発のスタートアップとして、こうしたデータ準備を含めたAI開発を伴走型で支援しています。AI PoCサービス「ココロミ」はスタンダードプランが月々250万円からで、どのようなデータをどの粒度で用意すべきかという設計段階からご一緒します。
まず現状を整理したい段階であれば、月額20万円で相談し放題の「AI×DX寺子屋」もご利用いただけます。
AI開発全体の流れは「【AI開発】基礎から徹底解説!AIの導入・開発フローをわかりやすく解説」、検証工程については「PoC検証とは?目的と3つの観点・進め方・成功事例を解説」もあわせてご覧ください。
参照元:各ツール・サービスの公式サイト(2026年9月時点)/株式会社EQUES「AIと化学分析を融合した繊維種識別手法の技術検討」
AIアノテーションに関するよくある質問
判定の難易度と種類の数によって変わるため、一律の目安はありません。まず少量で作成して精度を確認し、不足分を追加していく進め方が無駄になりません。最初から大量に作ると、基準の誤りが発覚したときの損失が大きくなります。
判定に業務の専門知識が必要なら社内、一般的な判定で件数が多いなら外部委託が向きます。併用も可能で、基準書の作成と検品を社内、本作業を外部とする分担が現実的です。
ある程度の精度のモデルが既にあれば、下書きを生成させて人が確認・修正する方法が有効です。ただし、AIの誤りをそのまま承認してしまうリスクがあるため、確認の手順は人手で作る場合より厳しく設計する必要があります。
全体の一部を複数人で重複して作業し、判断の一致率を測る方法が基本です。一致率が低い項目は基準書の記述が曖昧である可能性が高く、改訂の対象になります。
まとめ
AIアノテーションは、AI開発のなかで最も地道でありながら、精度の上限を決める工程です。品質を担当者の努力に委ねるのではなく、基準書と測定によって管理する仕組みを作ることが、遠回りに見えて最も確実な道になります。本記事の要点は次のとおりです。
- モデルの精度は教師データの一貫性を超えない。精度が頭打ちならまずデータを疑う
- 少量での試行と基準書の改訂を挟むことで、大規模なやり直しを防げる
- 品質は感覚ではなく一致率で測る。データの出所と権利の記録も作業前に済ませておく
どの粒度でデータを用意すべきか迷われている段階でも、課題の整理からご一緒できます。お気軽にご相談ください。最後までお読みいただき、ありがとうございました。
教師データの準備にお困りの方へ
どのデータをどの粒度で用意すべきか、設計段階からご一緒します。